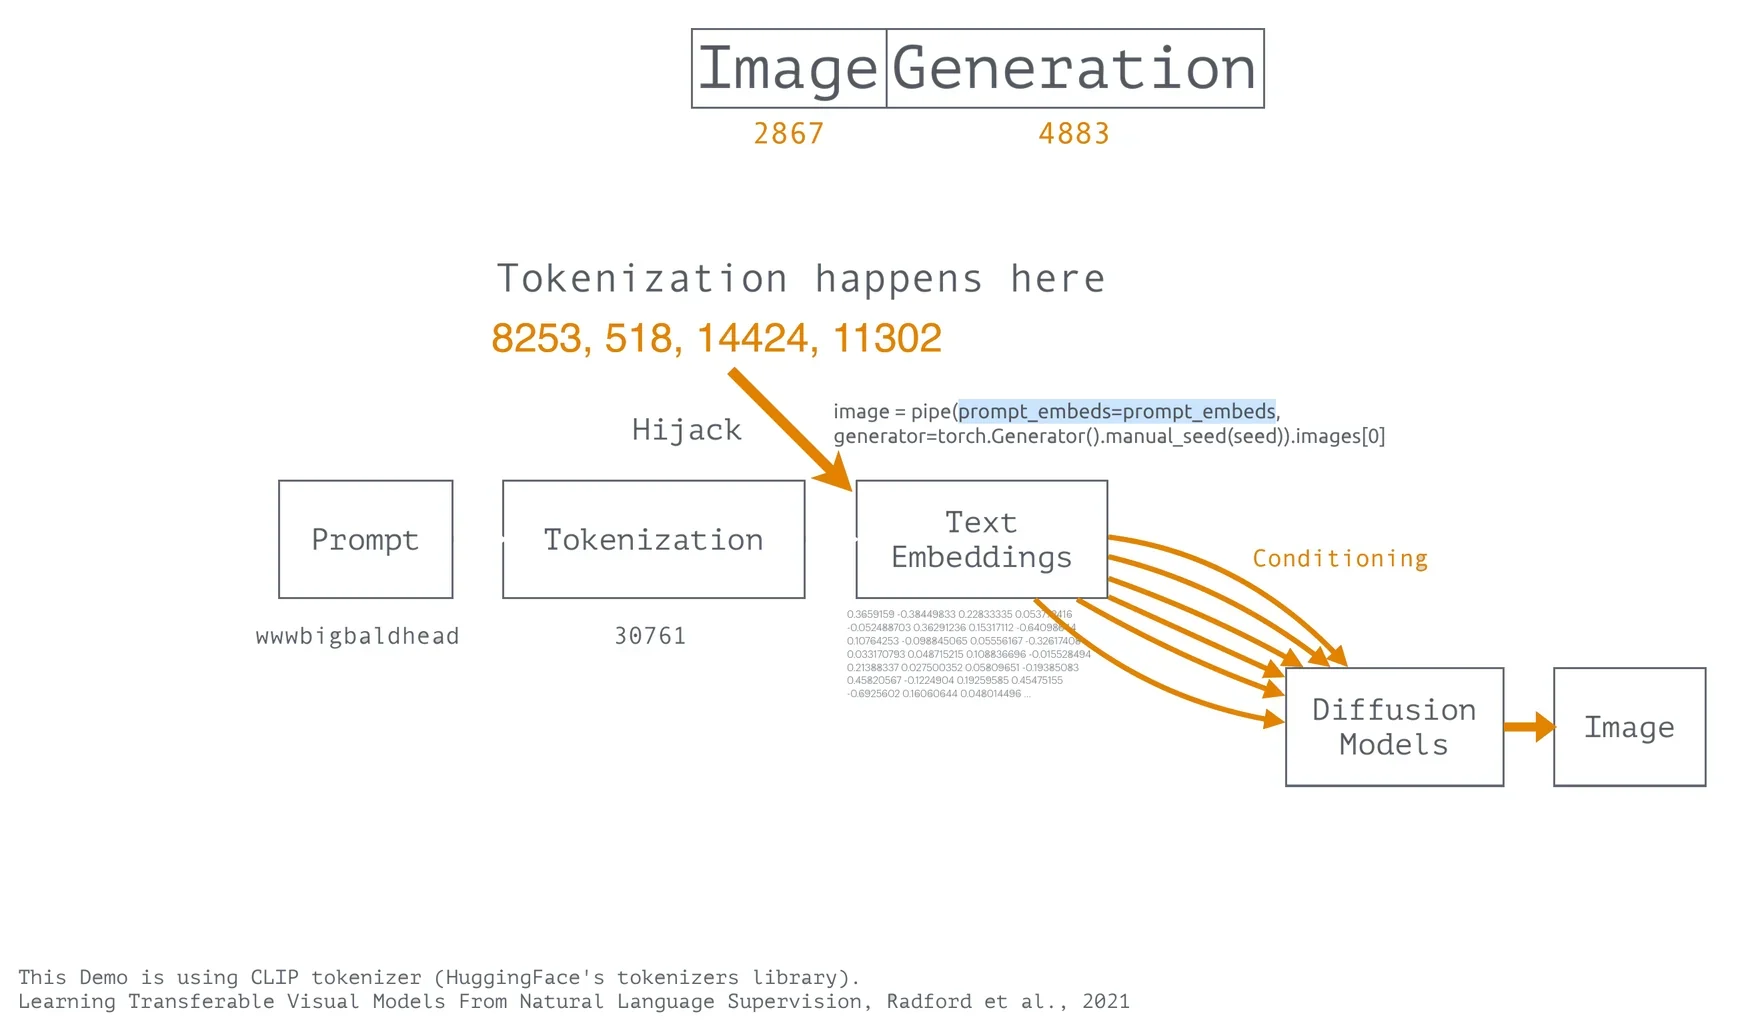
圖像生成器並不讀字。夾在中間的是像 CLIP 這樣的多模態基礎模型(Multimodal Foundation Model),用數億張圖片與圖說訓練而成。它有兩個編碼器:處理圖像的視覺 Transformer(Vision Transformer)與處理文字的 Transformer,把兩者放進同一個共享空間,讓一張圖和一句話可以用距離來比較。許多文字生成圖像模型都沿用 CLIP 的文字編碼器,來引導它們畫出什麼。
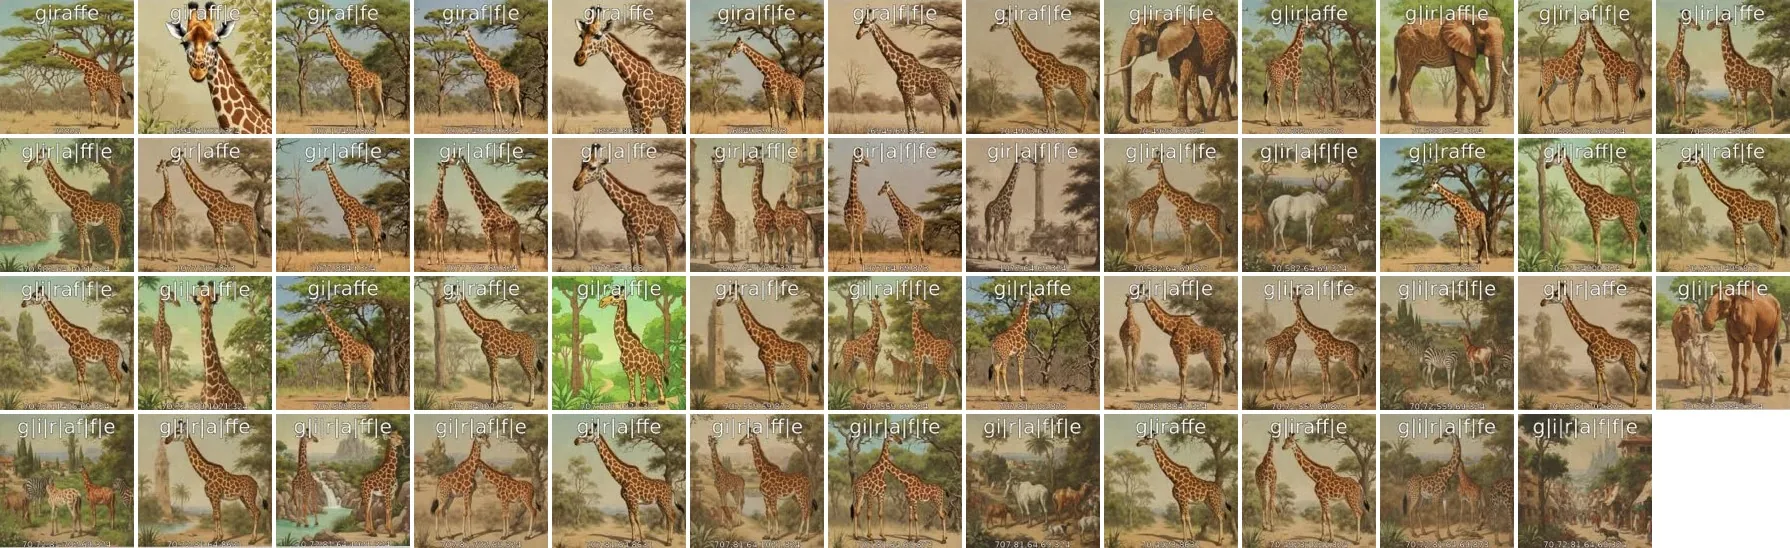
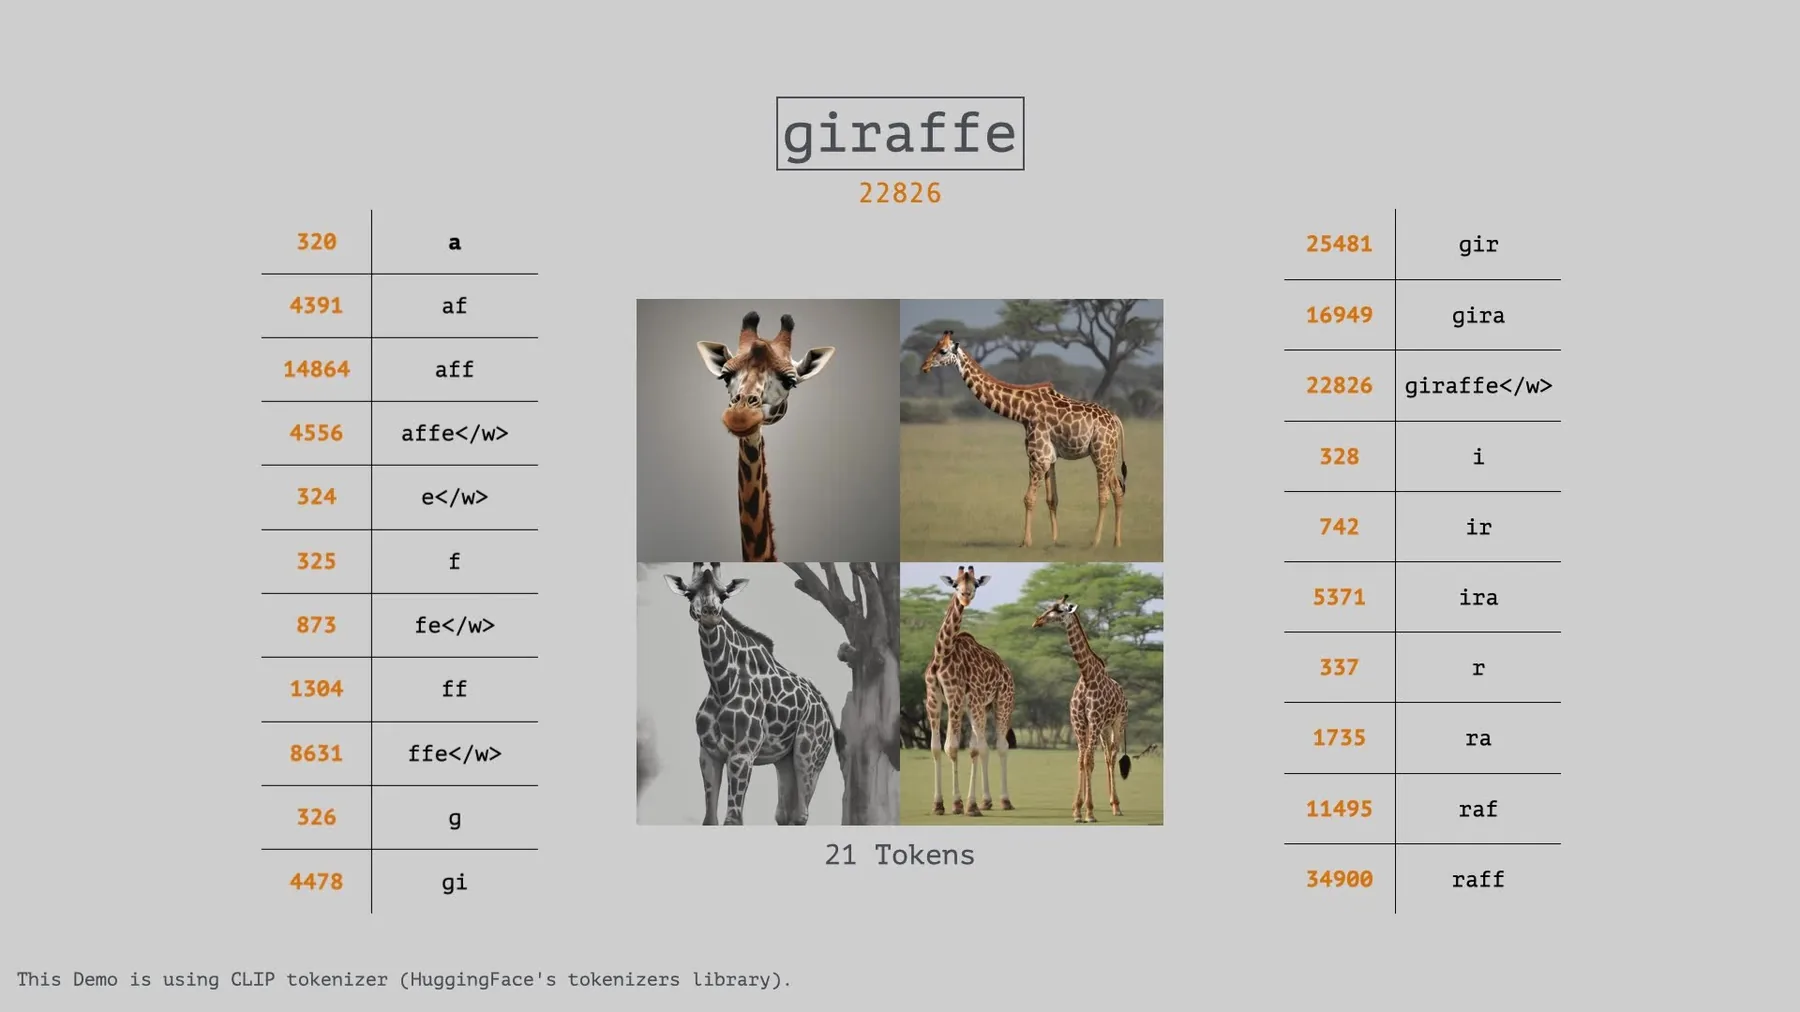
在這個編碼器讀到提示詞之前,分詞器會先把文字切成詞元(Token):從一本約 49,000 個條目的固定字典裡取出的碎片。「giraffe」本身就是其中一個,但同一個字也能用更小的碎片拼出來,共有 51 種拼法,從一整塊的 giraffe,到一個字母一個字母的 g|i|r|a|f|f|e。
劫持
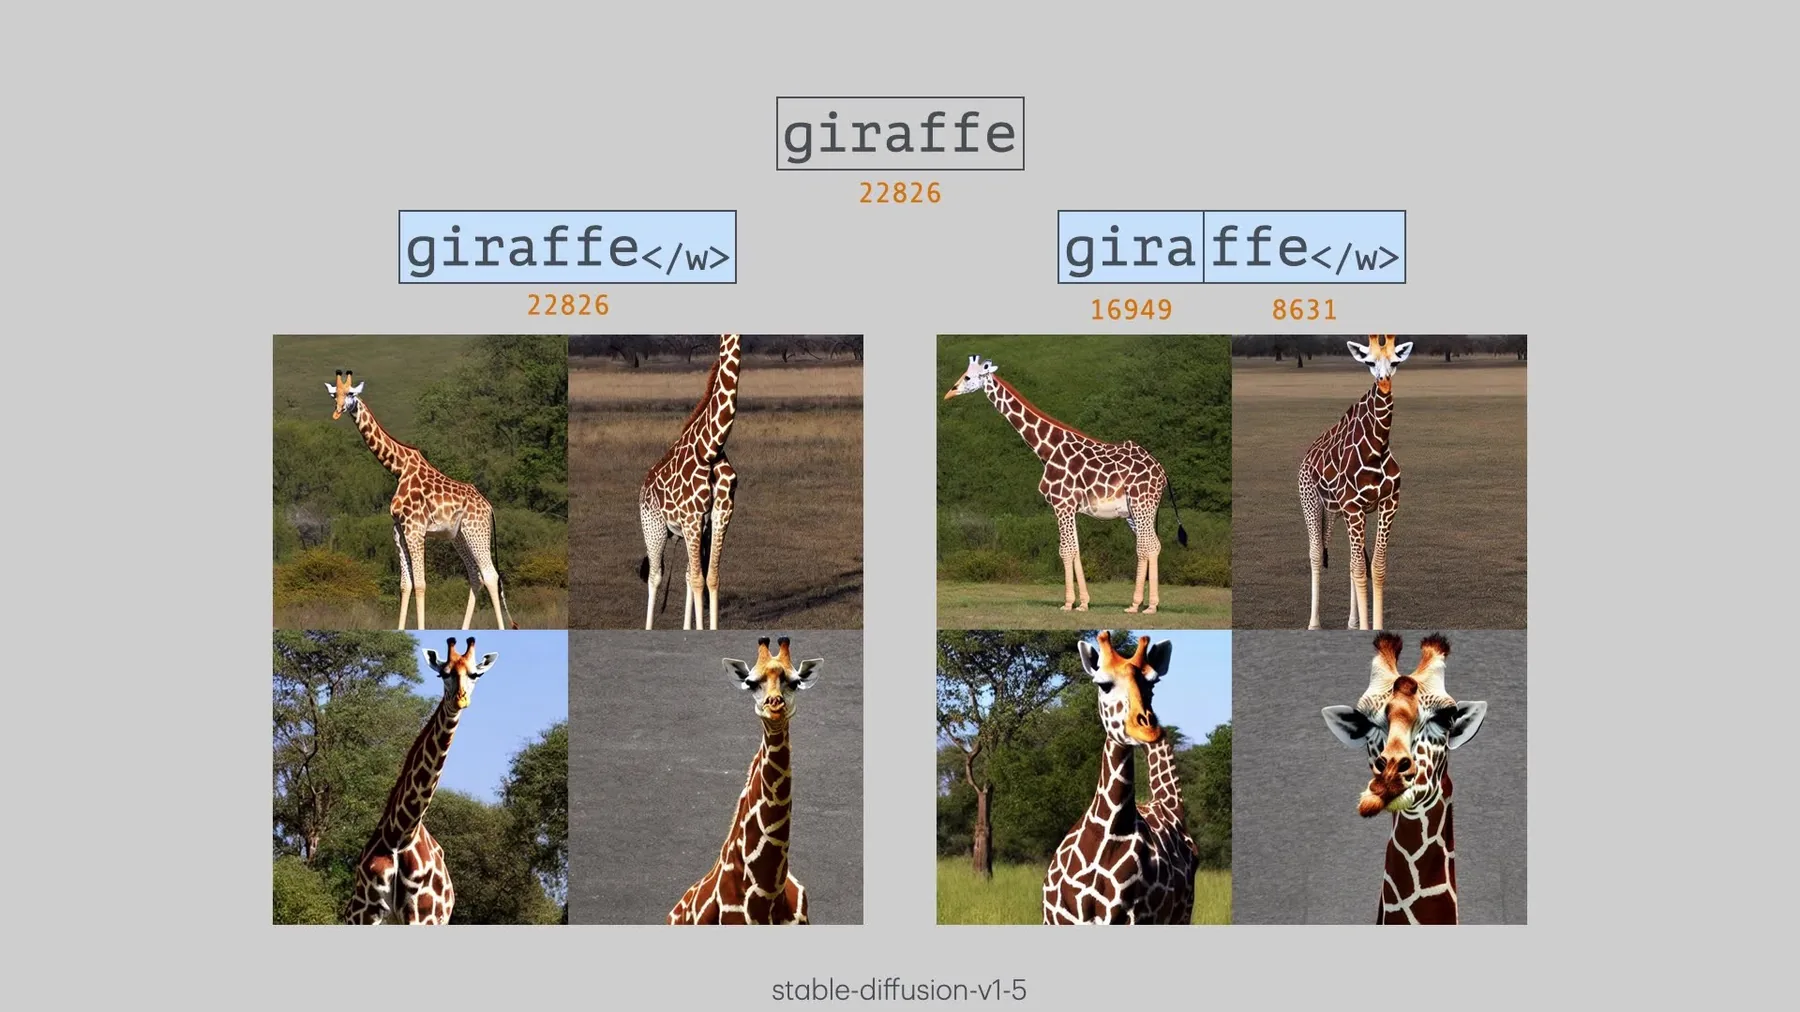
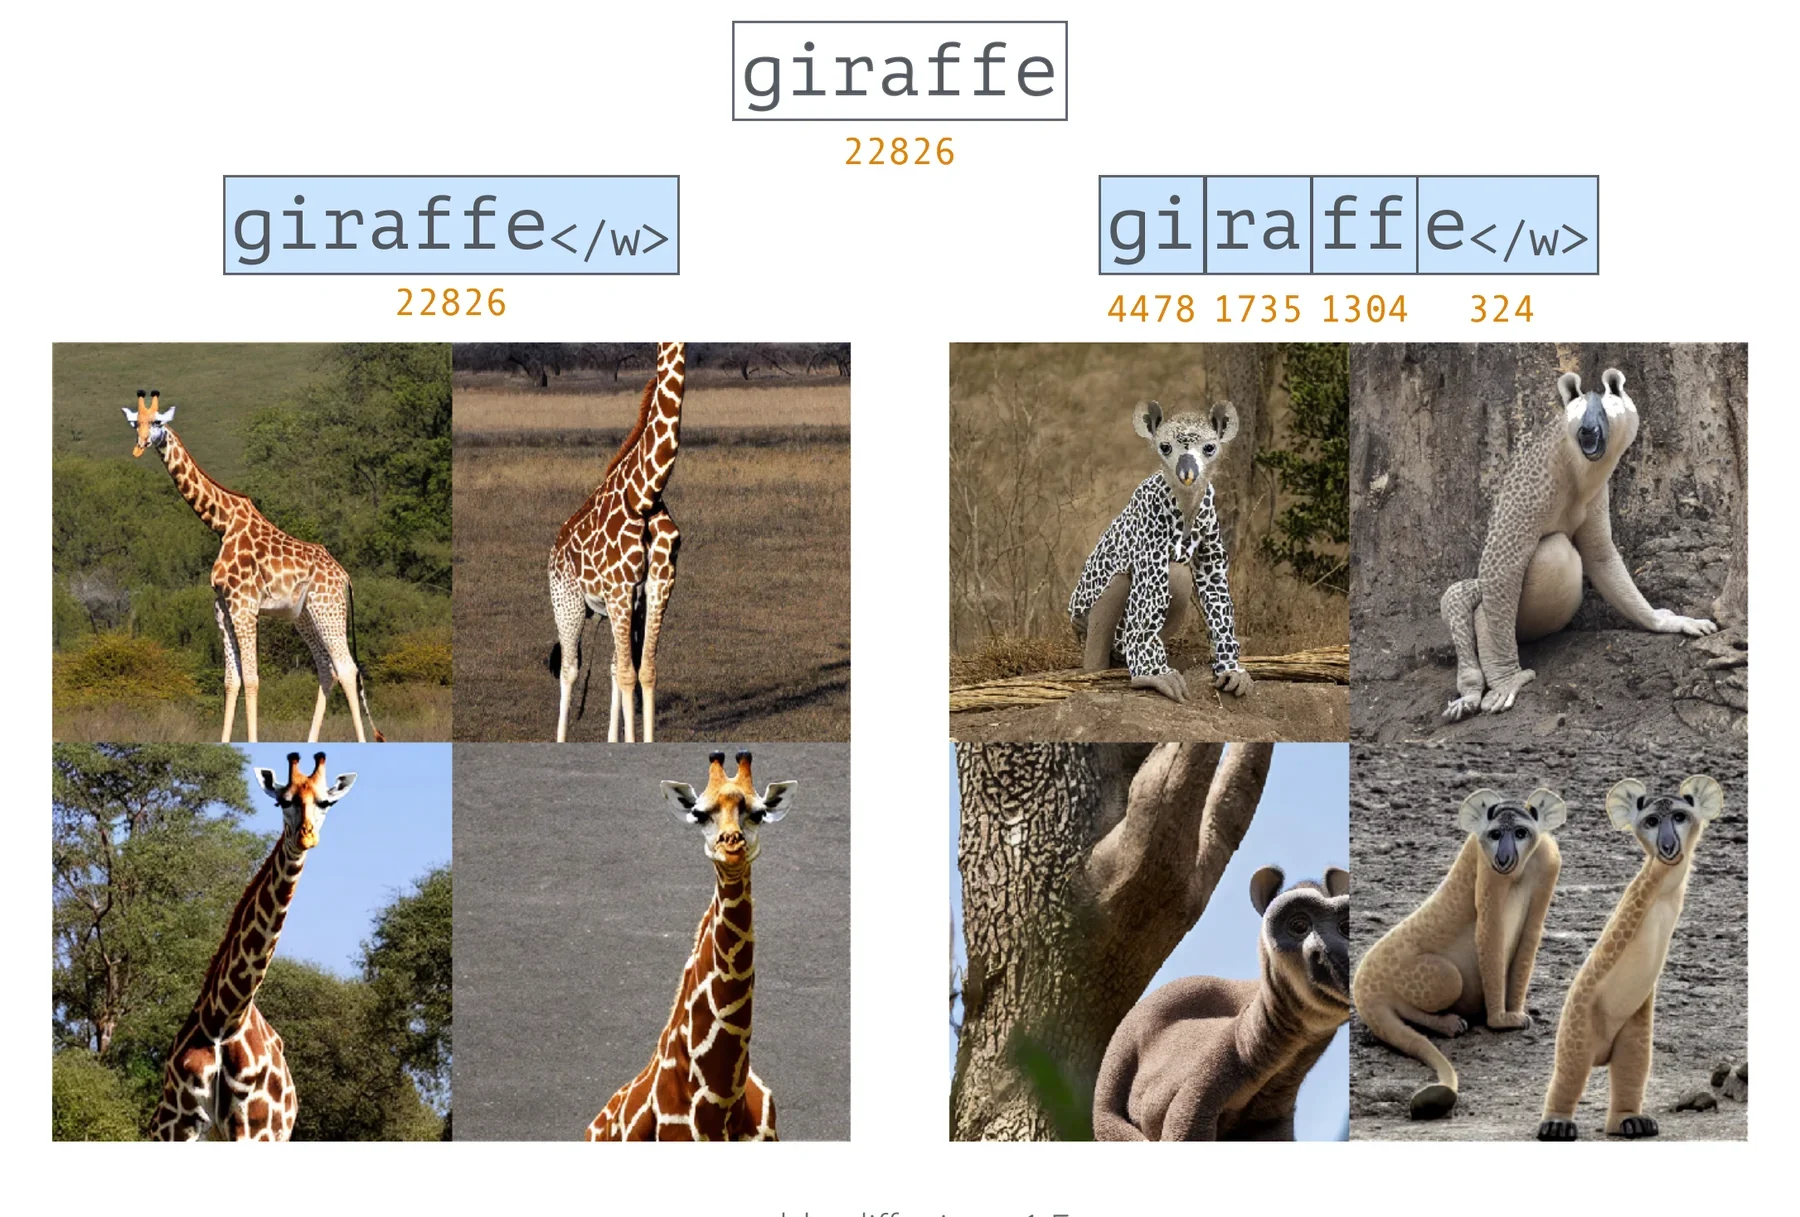
平常沒有人能選擇這些拼法:在提示詞框打下「giraffe」,分詞器永遠用同一種方式切開它。我們修改了一套開源的擴散模型管線,讓它跳過這一步,直接接收詞元編號,再以嵌入向量(Embedding)的形式交給文字編碼器。切法握在我們手上之後,每一種拼法都成了一個獨立的提示詞。模型收到的從來不是那個字,而是一小串數字:一整個 giraffe 是 22826;gira + ffe 是 16949、8631;gi + ra + ff + e 是 4478、1735、1304、324。
多數拼法仍然畫出長頸鹿:一整個詞元,或切成 gira|ffe,看起來差不多。切成 gi|ra|ff|e,卻變成介於狐猴和狗之間、帶著斑點的生物;其他拼法則漂向大象或馬。畫面出現什麼,不只取決於我們寫了什麼,也取決於字典怎麼切開它。
字典
這本字典並不中立。它以位元組對編碼(Byte Pair Encoding)建成:在從網路爬取的文字中,最常一起出現的字元組合被一次又一次合併成新的詞元。於是品牌名稱、平台用語與主題標籤成了單一詞元,較少見的字與非英文的字詞則被拆成長長一串碎片。有些字被刻意移除,某些圖像因此根本無法被要求出來。這一切,都在模型看過任何一張圖之前就已經決定。
這項研究把這個隱藏的層次當作一種自成一格的語言來閱讀:它是為誰而寫,它遺漏了什麼,又放行了什麼。
講演
《51 Ways to Spell the Image Giraffe: The Hidden Politics of Token Languages in Generative AI》,第 39 屆混沌通訊大會(39C3),漢堡,2025 年 12 月,與 Leon-Etienne Kühr 合作。錄影可在 media.ccc.de 觀看。
相關作品《Sixteen Tokens for a Cave》不研究這些詞元,而是用它們來書寫。
Talk and research: Ting-Chun Liu, Leon-Etienne Kühr
Images: slides from the talk, 39C3, 2025; photograph of the speakers: still from the recording, media.ccc.de, CC BY 4.0