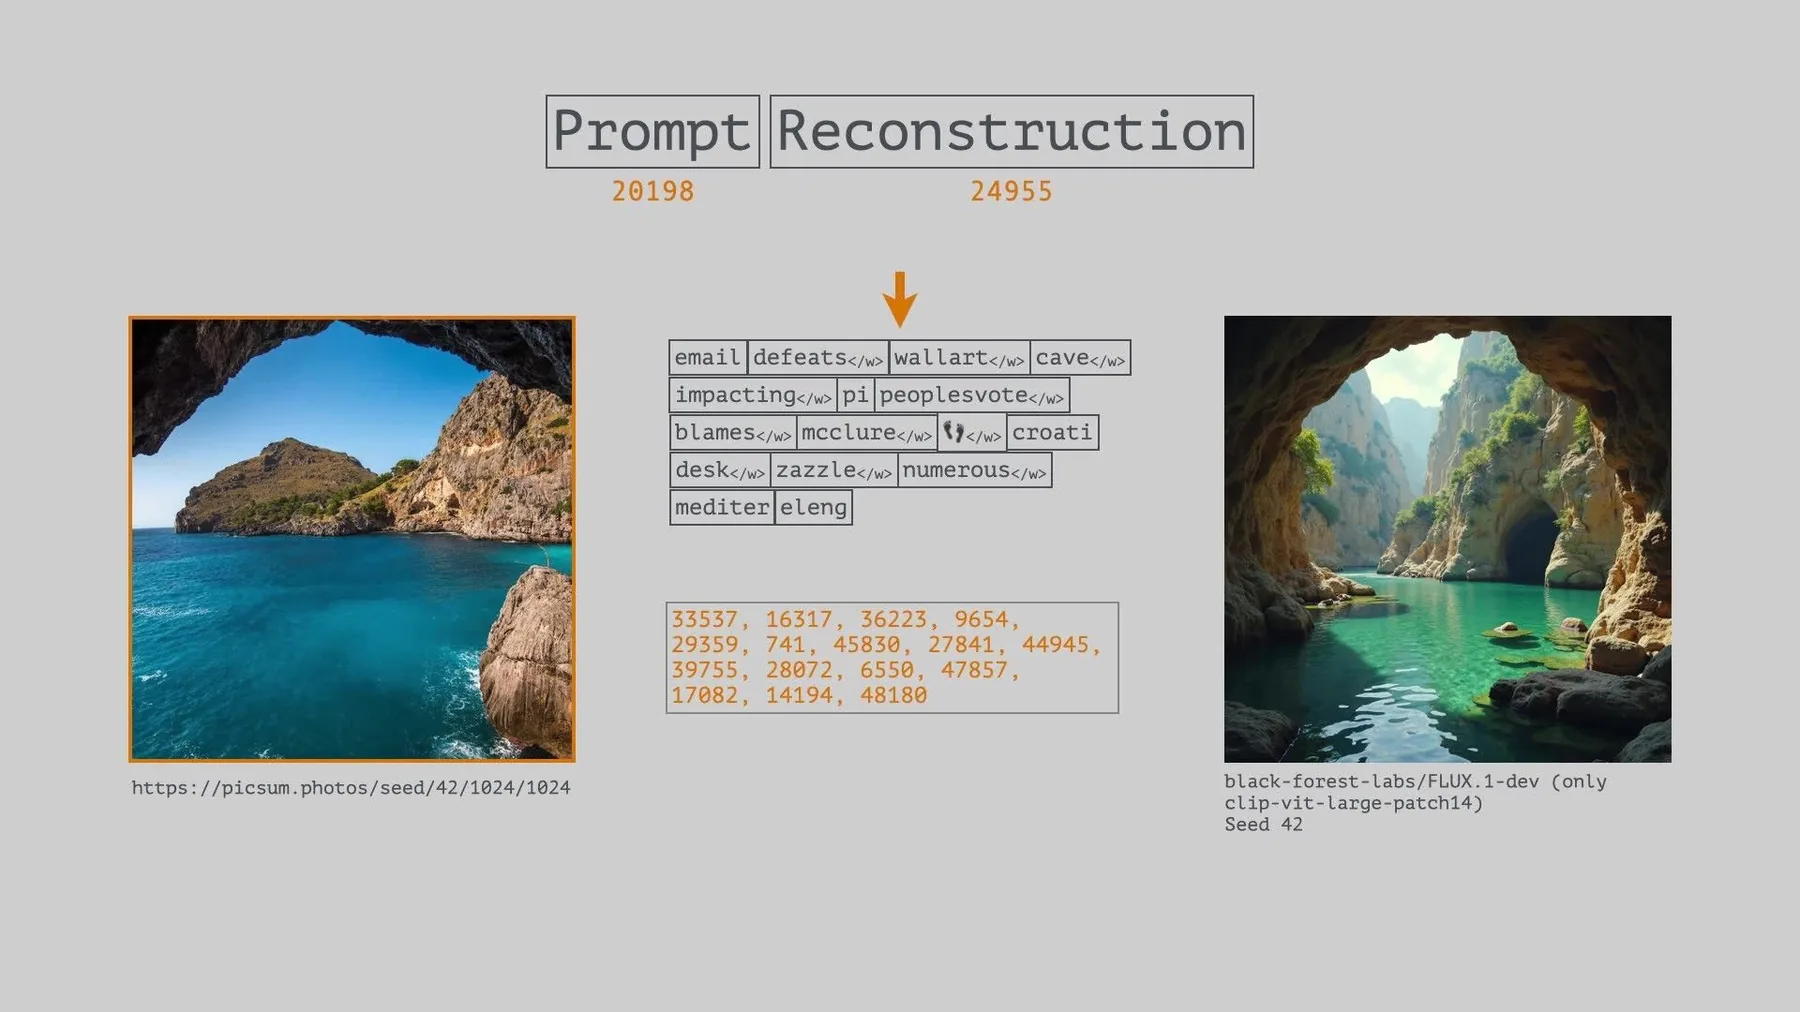
email, defeats, wallart, cave, impacting, pi, peoplesvote, blames, mcclure, 👣, croati, desk, zazzle, numerous, mediter, eleng
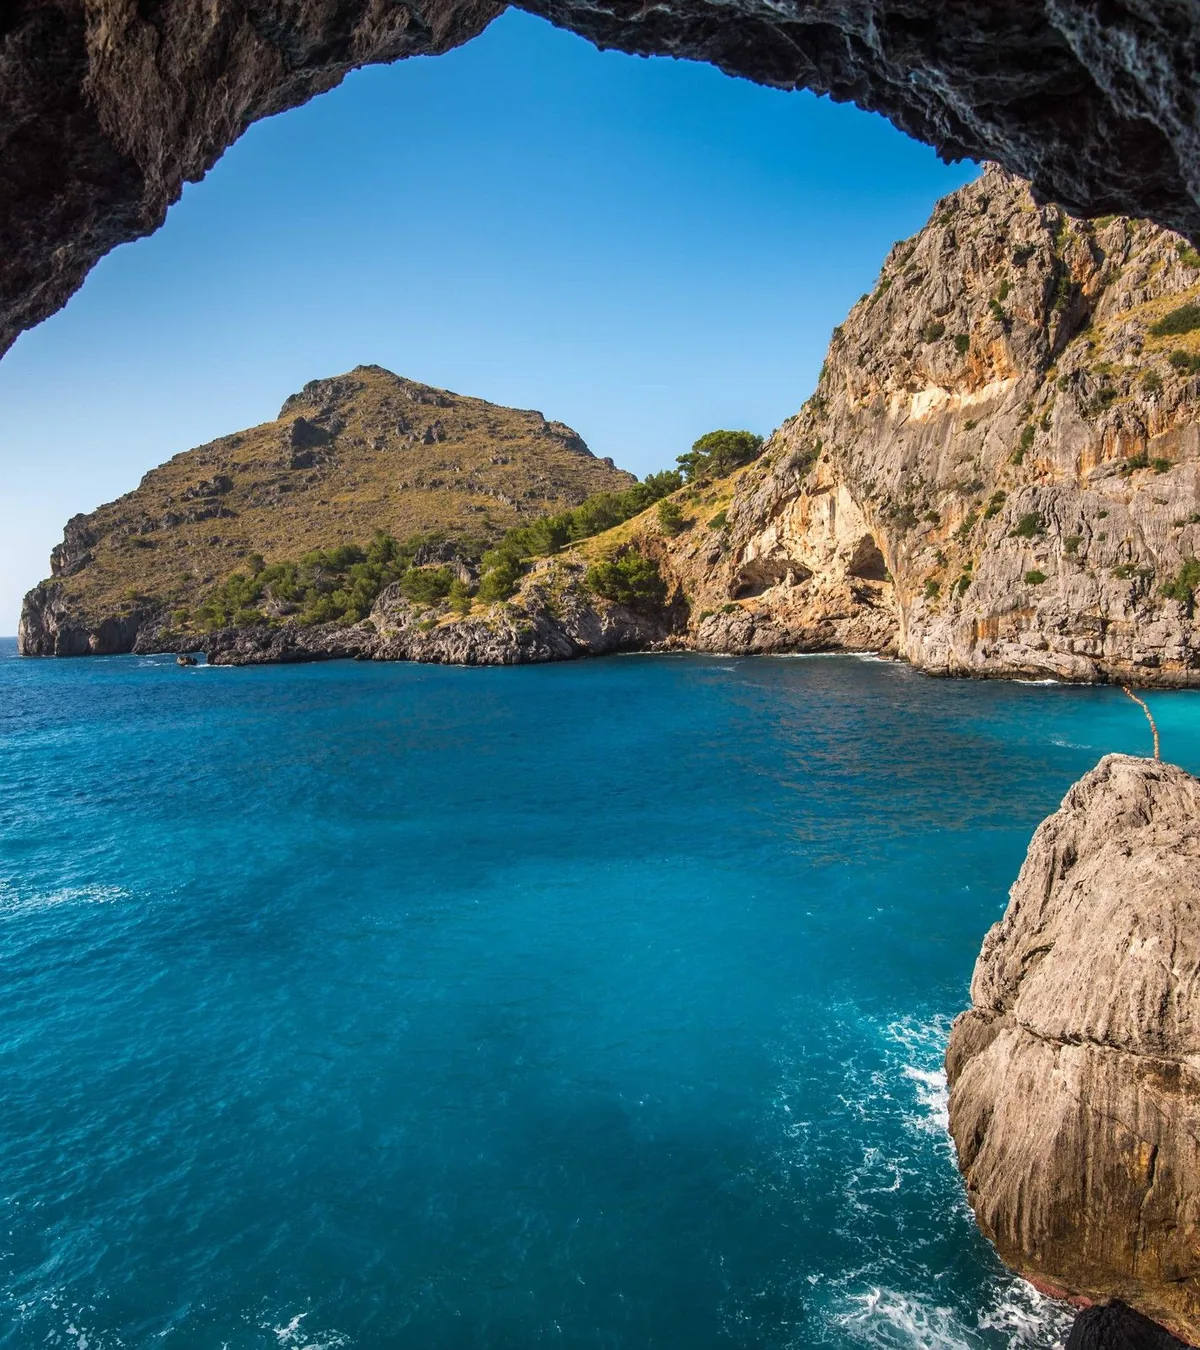
這十六個詞元(Token)描述的是一張海蝕洞的照片。它們是寫給機器的,沒有任何人挑選過它們。圖說永遠無法窮盡一張圖,圖像也常常逃離語言;無論從哪個方向,都不存在一個正確的描述。
這台機器是 CLIP,一個許多圖像生成器用來連結圖片與文字的多模態基礎模型(Multimodal Foundation Model)。視覺 Transformer(Vision Transformer)把照片轉成一個向量,文字 Transformer 也把一串詞元轉成向量,兩個向量越朝同一個方向,分數就越高。CLIP 約 49,000 個詞元的字典,同時是它的詞彙,也是它衡量一句話與一張圖有多相符的尺。
遺傳演算法
這串詞元是培育出來的,不是寫出來的。遺傳演算法模仿演化:先產生一群隨機的詞元序列,逐一和照片比對打分,留下最好的,再用它們繁殖下一代:把兩條序列交叉互換,並隨機突變其中幾個詞元。經過兩百代、每代 2048 個候選,序列一點一點靠近那張圖,最後停在一個局部最佳解:眾多可能答案中的一個,而不是唯一正確的答案。一張圖能得出許多序列,每一條序列又能生出許多圖。
結果讀起來像雜訊:croati、mediter 這類只剩一半的字,一個商店名稱,一個政治標籤,一串腳印。然而從未參與這場搜尋的圖像模型,卻能從中畫出一個洞穴。這些詞元以數字的形式直接交給每個模型,跳過把文字切成詞元的那一步,所以這首詩只存在於機器自己的詞彙裡。
這件作品把這樣的序列當作寫給機器的詩來讀,它在兩個方向上都是對抗性的:對模型而言,它本為自然語言而設計,這裡卻只被拿來對著自己的分數最佳化;對人類讀者而言,它是一種拒絕被轉述的書寫。我們不是收信人,只是在一旁偷聽。
同一個提示詞,四個模型
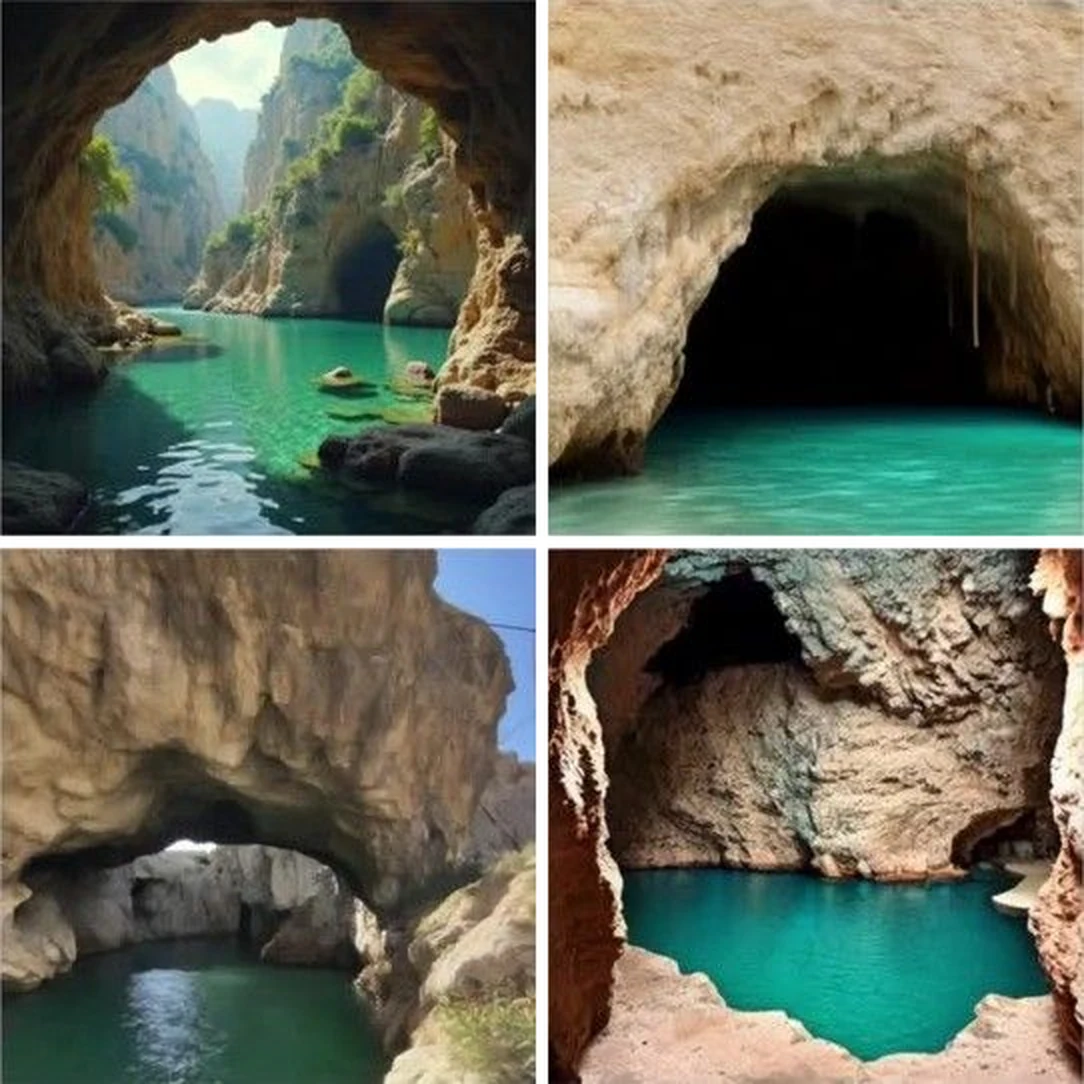
實際的提示詞就只是這十六個數字,一個詞元一個:33537, 16317, 36223, 9654, 29359, 741, 45830, 27841, 44945, 39755, 28072, 6550, 47857, 17082, 14194, 48180。同樣這十六個數字交給四個完全沒有參與搜尋的圖像生成器,每一個都畫出了自己的海蝕洞:FLUX.1-dev 與 Stable Diffusion 3.5 Medium(兩者都只用 CLIP ViT-L/14 文字編碼器)、Stable Diffusion XL Base 1.0,以及 Stable Diffusion 1.5。簡單來說:一串對人毫無意義的數字,在不同的機器裡都能把那張照片重新叫回來。
比文字更接近
CLIP 判斷這張照片與五種描述有多接近:
(偷懶的)人類,“a photo of a cave and the ocean”:0.272
這十六個詞元:0.433
ChatGPT:0.258
JoyCaption Beta One:0.271
Gemini:0.273
這十六個詞元分數最高,是因為搜尋推高的正是這個分數。真正重要的是,從未看過這場搜尋的其他圖像模型,依然把它們讀成一個洞穴。
提示詞重建
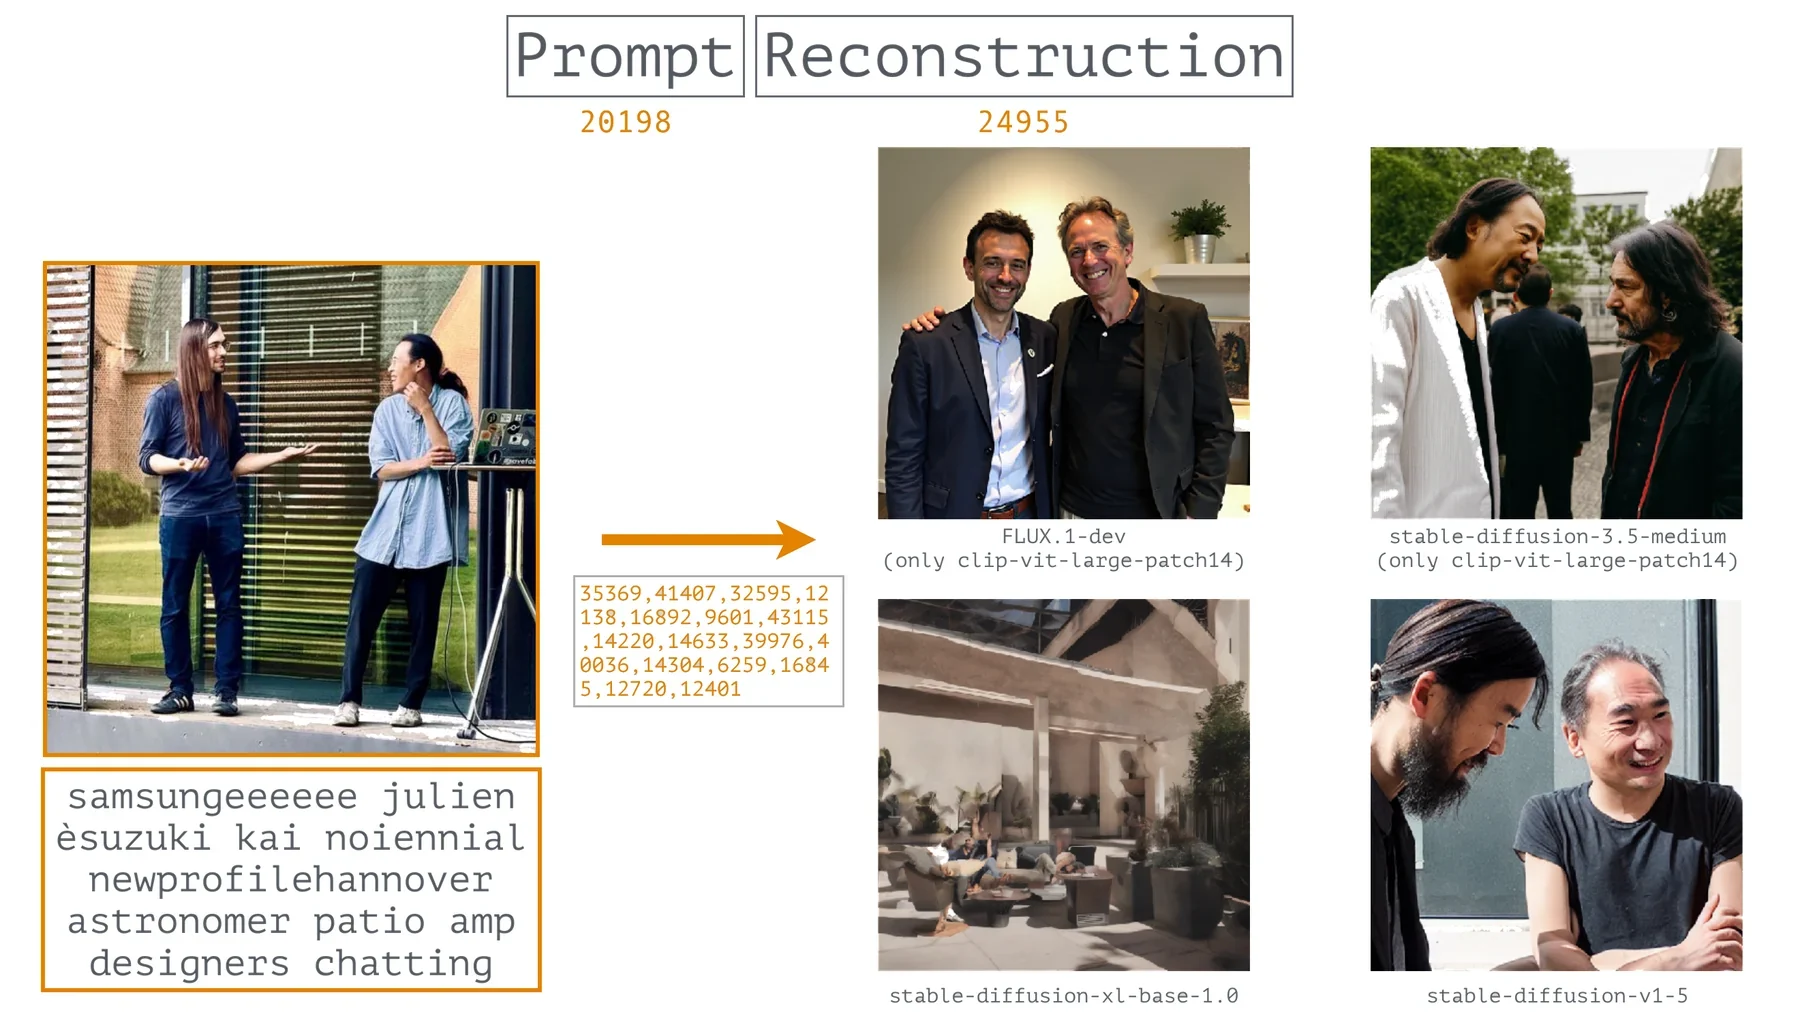
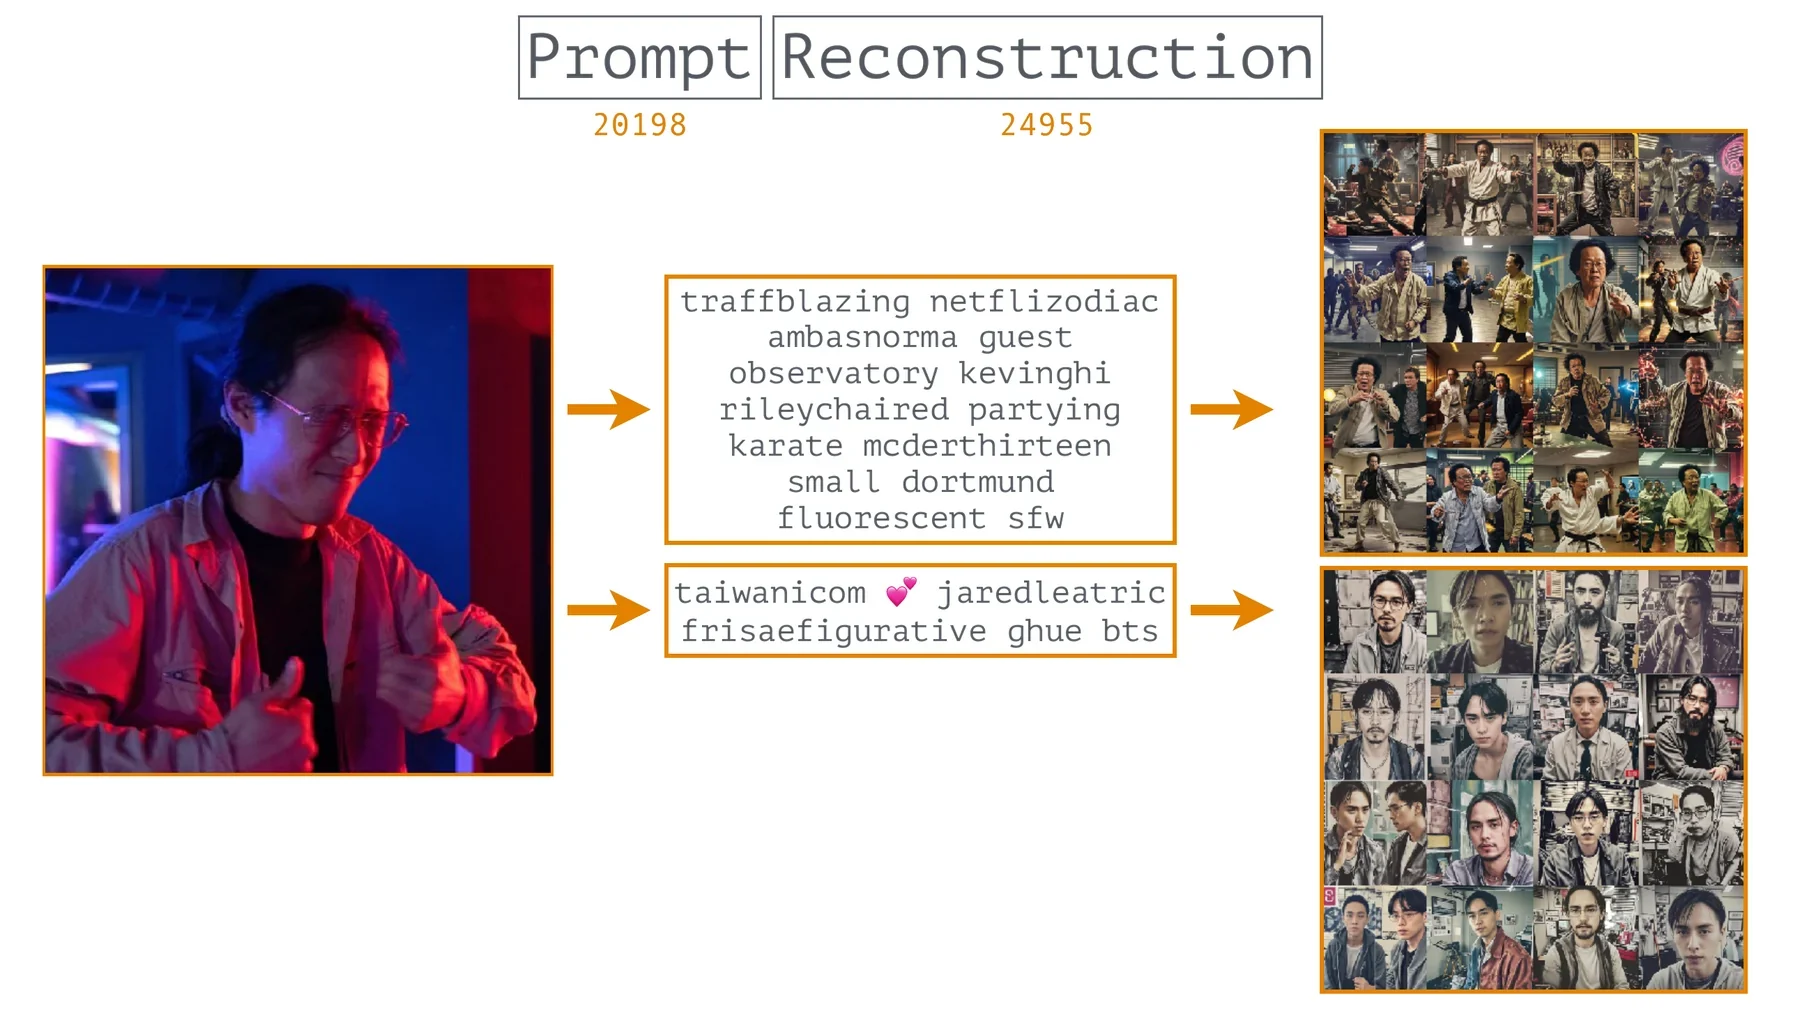
同樣的方法也能用在人的照片上。從一張兩個人在戶外交談的照片培育出來的「samsungeeeee julien èsuzuki kai noiennial newprofilehannover astronomer patio amp designers chatting」,讓 FLUX.1-dev、Stable Diffusion 3.5、SDXL 與 Stable Diffusion 1.5 各自畫出兩個人交談的畫面。
狀態
開發中。初步版本曾以「Prompt Reconstruction」之名,在講演《51 Ways to Spell the Image Giraffe》中展示(39C3,漢堡,2025)。
Artists and developers: Ting-Chun Liu, Leon-Etienne Kühr
Target photograph: Stefan Kunze / Unsplash
Four-image grid, row by row: FLUX.1-dev, Stable Diffusion 3.5 medium, Stable Diffusion XL, Stable Diffusion 1.5