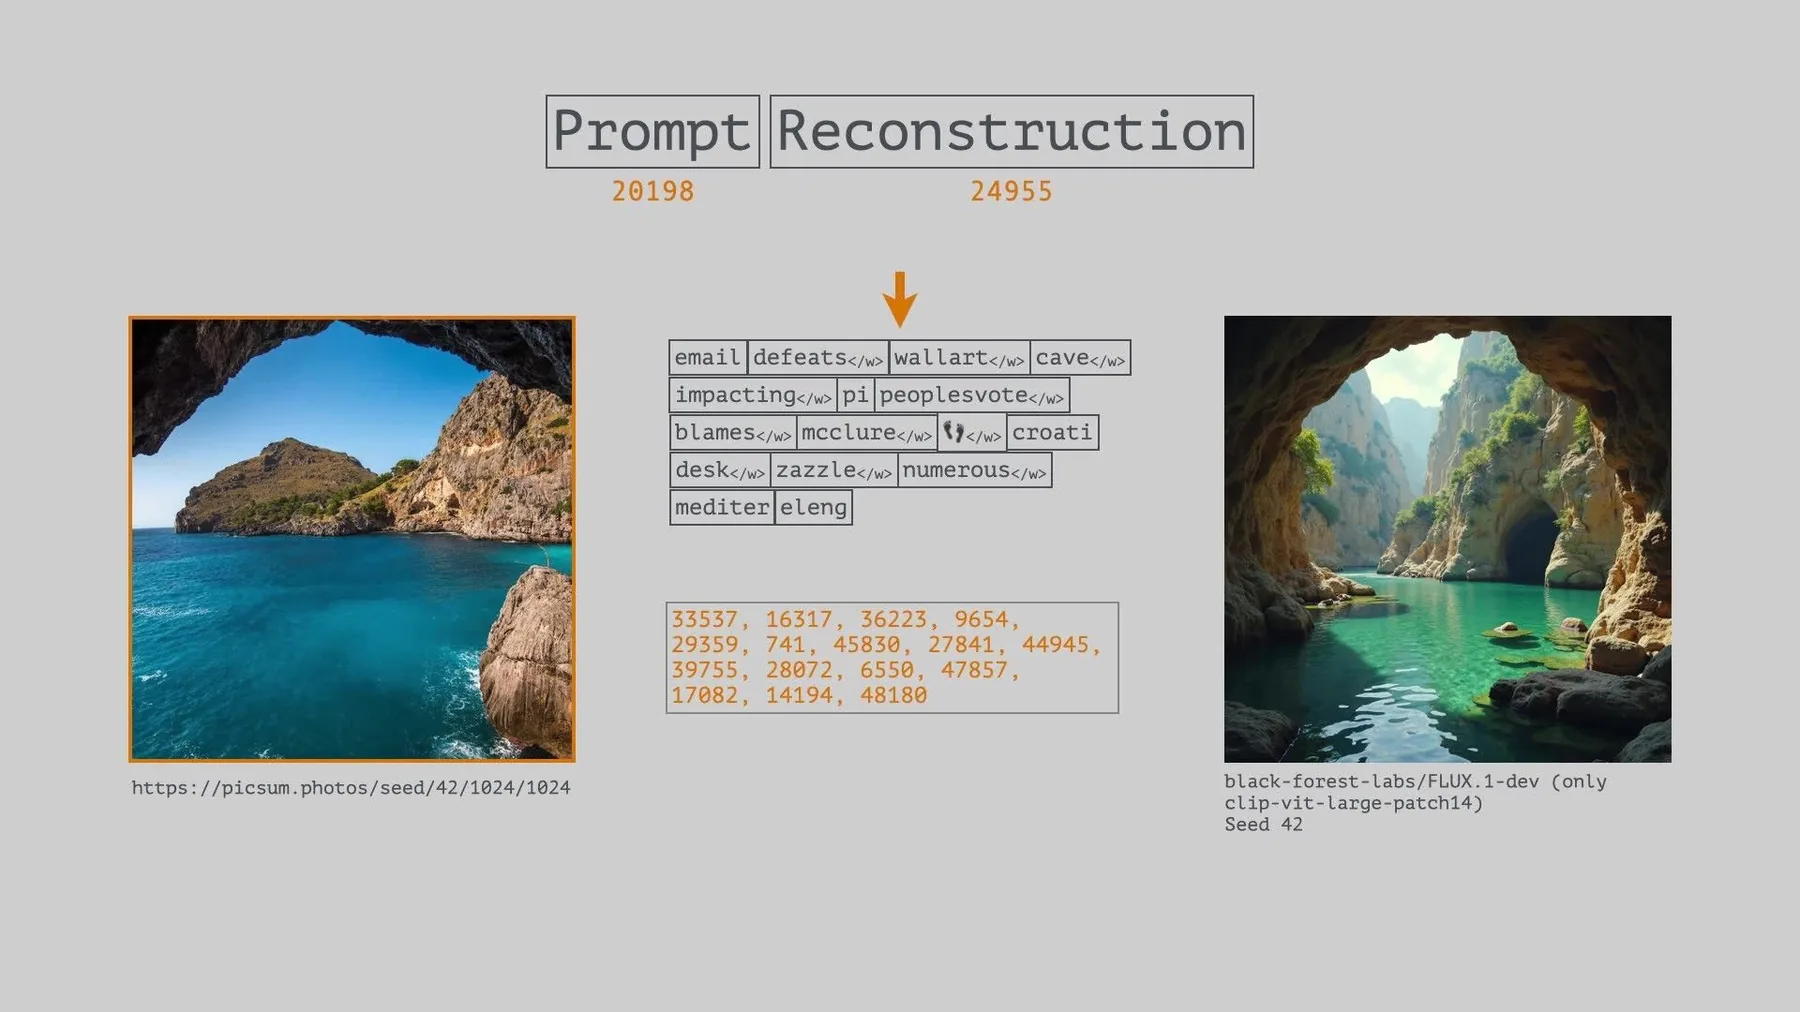
email, defeats, wallart, cave, impacting, pi, peoplesvote, blames, mcclure, 👣, croati, desk, zazzle, numerous, mediter, eleng
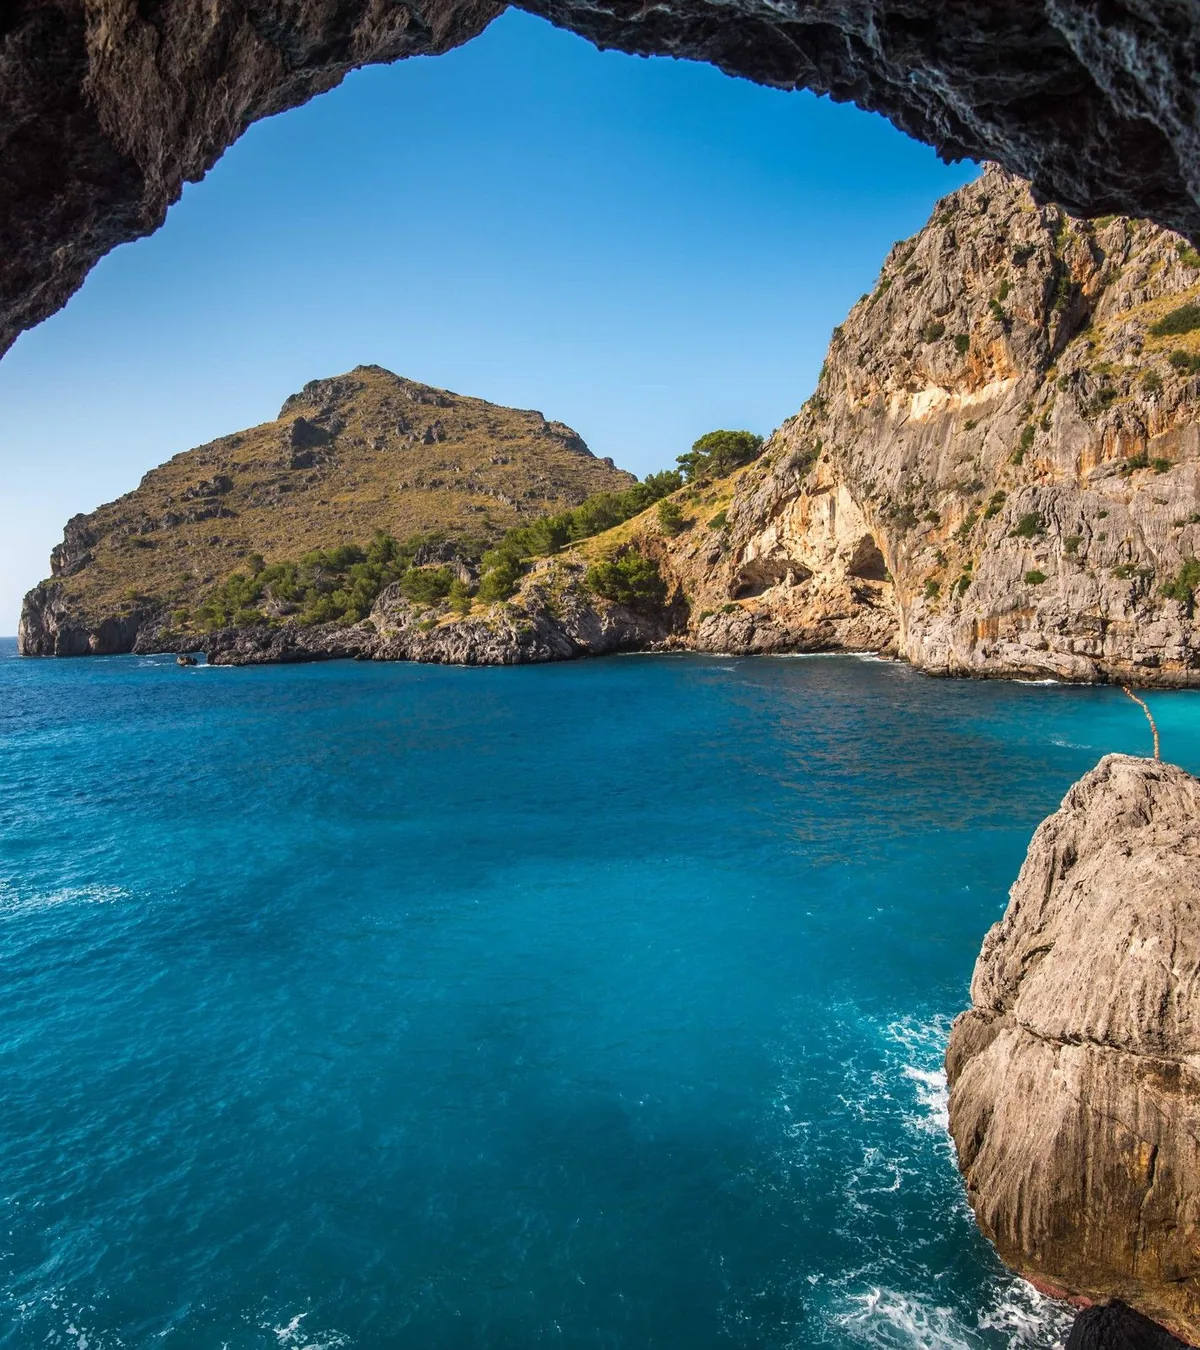
Diese sechzehn Token beschreiben das Foto einer Meeresgrotte. Sie wurden für eine Maschine geschrieben, und kein Mensch hat sie ausgewählt. Bildunterschriften erschöpfen ein Bild nie, und Bilder entziehen sich oft der Sprache; in keiner Richtung gibt es eine richtige Beschreibung.
Die Maschine ist CLIP, ein multimodales Foundation-Modell, mit dem viele Bildgeneratoren Bilder und Wörter verbinden. Ein Vision Transformer macht aus dem Foto einen Vektor, ein Text-Transformer aus einer Folge von Token ebenso, und je mehr die beiden in dieselbe Richtung zeigen, desto höher der Wert. CLIPs Wörterbuch mit rund 49.000 Token ist zugleich sein Vokabular und sein Maß dafür, wie gut ein Satz zu einem Bild passt.
Ein genetischer Algorithmus
Die Folge wurde gezüchtet, nicht geschrieben. Ein genetischer Algorithmus ahmt die Evolution nach: Er beginnt mit einer Population zufälliger Token-Folgen, bewertet jede am Foto, behält die besten und züchtet daraus die nächste Generation, indem er zwei Folgen kreuzt und einzelne Token zufällig mutiert. Über zweihundert Generationen mit je 2048 Kandidaten näherten sich die Folgen dem Bild und blieben bei einem lokalen Optimum stehen: eine von vielen möglichen Antworten, nicht die richtige. Ein Bild ergibt viele Folgen, und jede Folge ergibt viele Bilder.
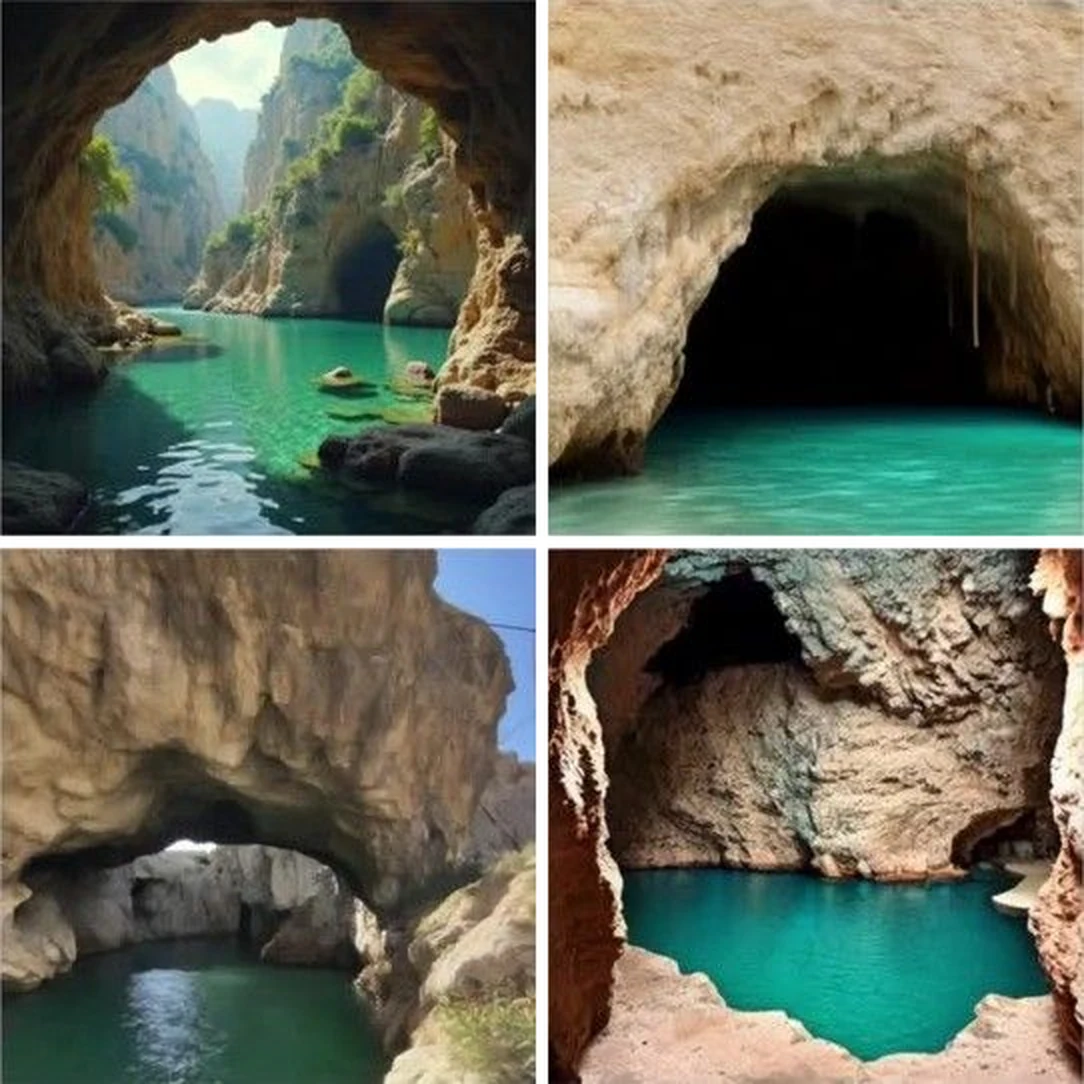
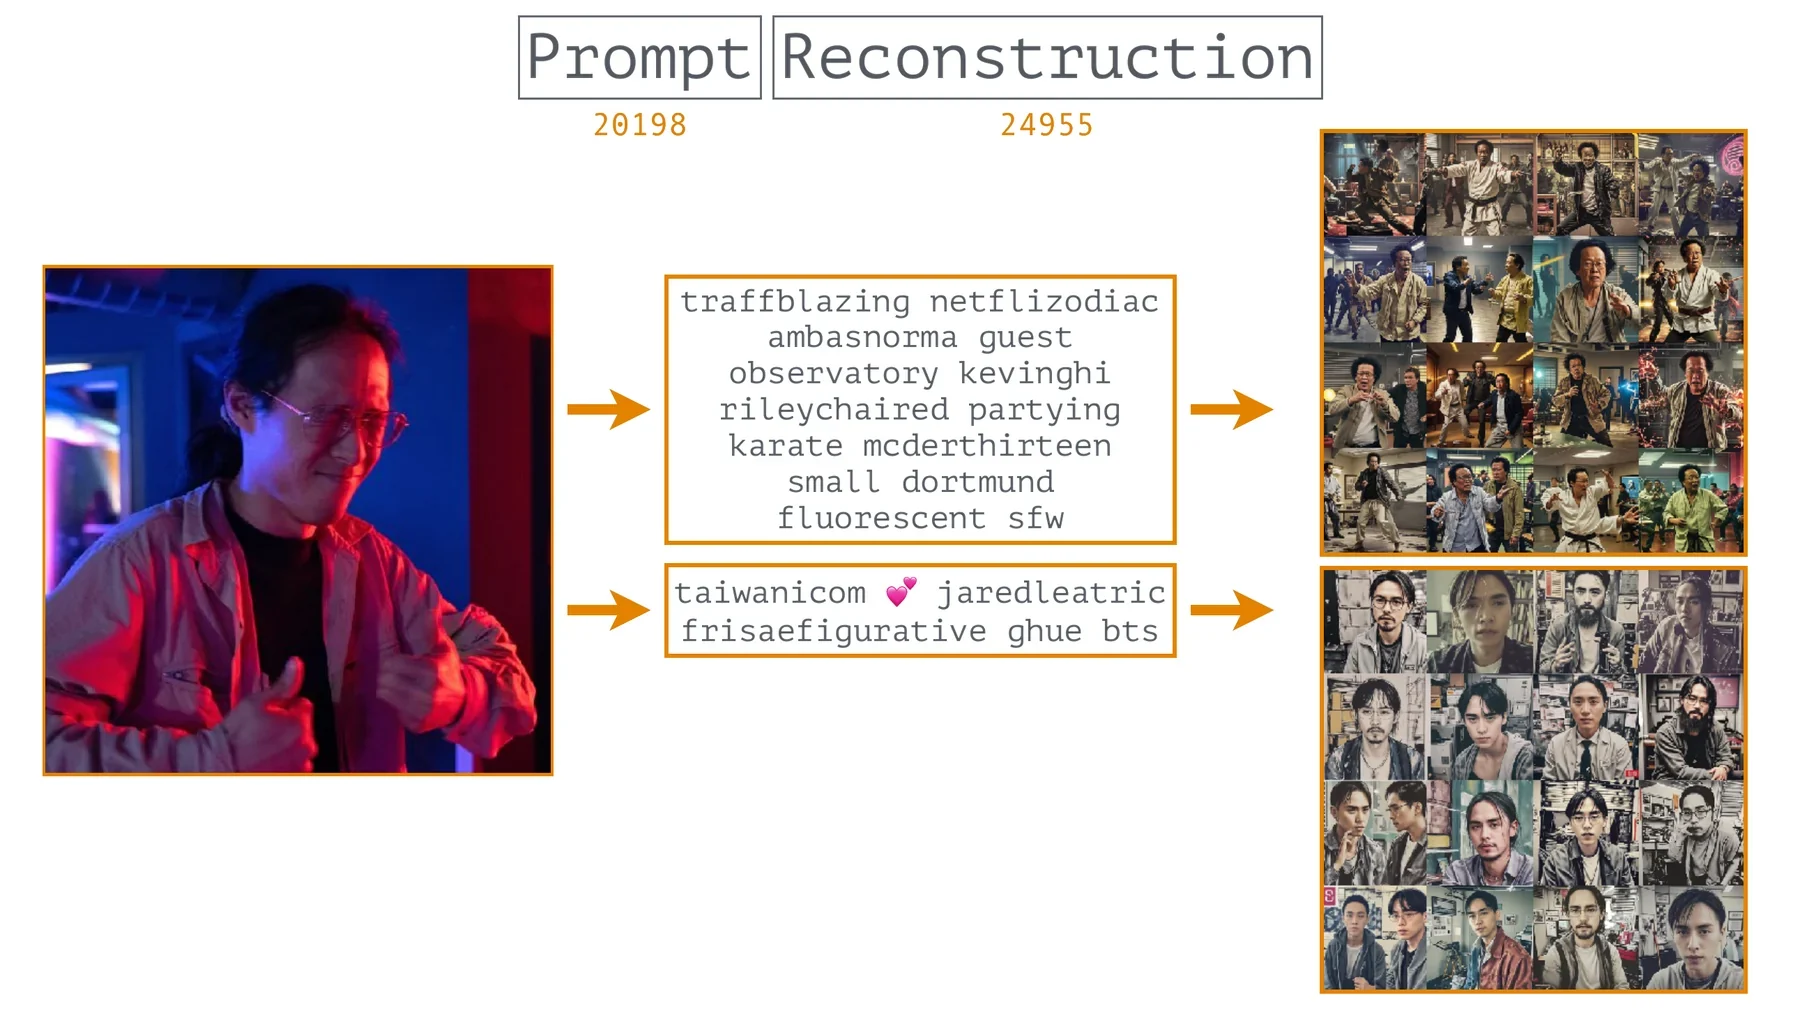
Das Ergebnis liest sich wie Rauschen: Halbwörter wie croati und mediter, ein Shopname, ein politischer Hashtag, Fußspuren. Doch Bildmodelle, die an der Suche nicht beteiligt waren, zeichnen daraus eine Grotte. Die Token werden jedem Modell als Zahlen übergeben, unter Umgehung des Schritts, in dem geschriebener Text in Token zerlegt würde; das Gedicht existiert nur im eigenen Vokabular der Maschine.
Die Arbeit liest solche Folgen als Poesie für Maschinen, adversarial in zwei Richtungen: gegenüber dem Modell, das für natürliche Sprache gebaut ist und hier nur gegen seinen eigenen Wert optimiert wird, und gegenüber menschlichen Leser*innen, als Schreiben, das sich der Paraphrase widersetzt. Wir sind nicht die Adressat*innen; wir hören nur mit.
Derselbe Prompt, vier Modelle
Der eigentliche Prompt besteht nur aus diesen sechzehn Zahlen, eine pro Token: 33537, 16317, 36223, 9654, 29359, 741, 45830, 27841, 44945, 39755, 28072, 6550, 47857, 17082, 14194, 48180. Dieselben sechzehn Zahlen gingen an vier Bildgeneratoren, die an der Suche nicht beteiligt waren, und jeder zeichnete seine eigene Meeresgrotte: FLUX.1-dev und Stable Diffusion 3.5 Medium (beide nur mit ihrem CLIP-ViT-L/14-Text-Encoder), Stable Diffusion XL Base 1.0 und Stable Diffusion 1.5. Einfach gesagt: Eine Zahlenliste, die einem Menschen nichts sagt, holt das Bild in verschiedenen Maschinen zurück.
Näher als Worte
Wie nah CLIP das Foto und fünf Beschreibungen davon findet:
(fauler) Mensch, „a photo of a cave and the ocean“: 0,272
die sechzehn Token: 0,433
ChatGPT: 0,258
JoyCaption Beta One: 0,271
Gemini: 0,273
Die Token liegen vorn, weil die Suche genau diesen Wert in die Höhe getrieben hat. Entscheidend ist, dass andere Bildmodelle, die die Suche nie gesehen haben, sie trotzdem als Höhle lesen.
Prompt-Rekonstruktion
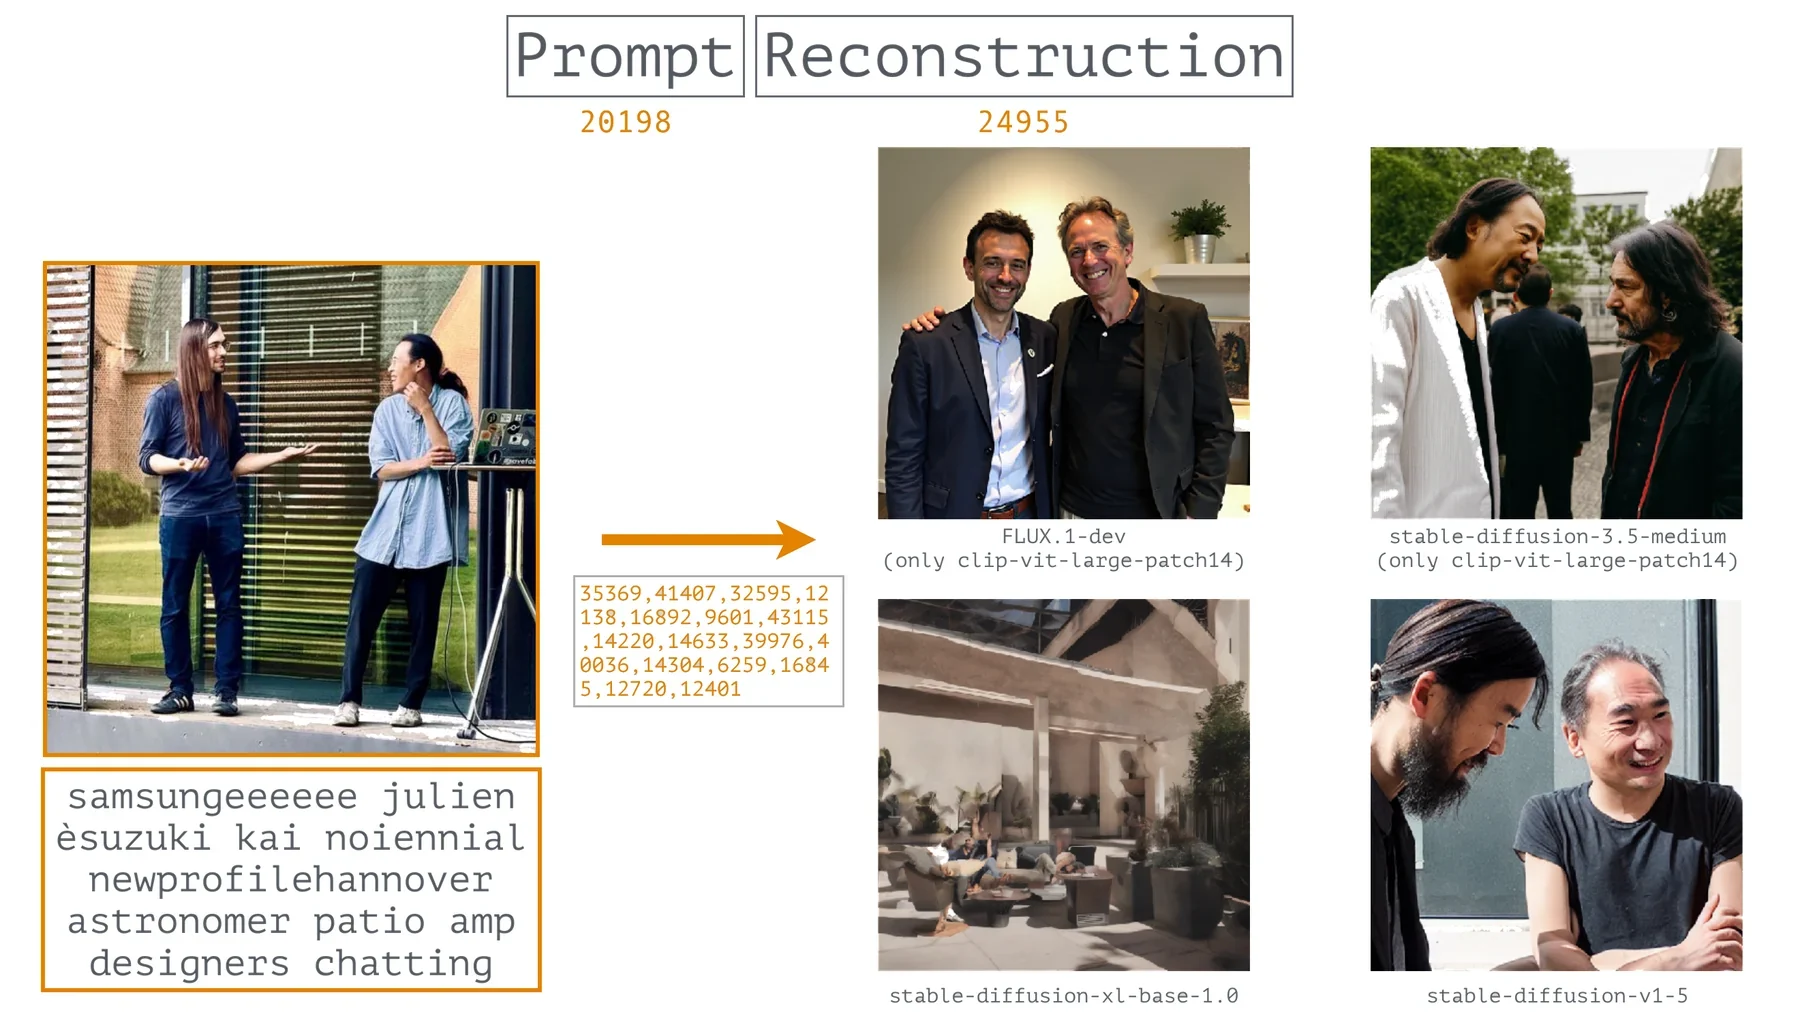
Dieselbe Methode funktioniert mit Fotos von Menschen. Aus einem Schnappschuss zweier Menschen im Gespräch gezüchtet, lässt „samsungeeeee julien èsuzuki kai noiennial newprofilehannover astronomer patio amp designers chatting“ FLUX.1-dev, Stable Diffusion 3.5, SDXL und Stable Diffusion 1.5 jeweils eine eigene Version zweier Menschen im Gespräch zeichnen.
Stand
In Entwicklung. Eine erste Fassung wurde als „Prompt Reconstruction“ im Vortrag 51 Ways to Spell the Image Giraffe gezeigt (39C3, Hamburg, 2025).
Artists and developers: Ting-Chun Liu, Leon-Etienne Kühr
Target photograph: Stefan Kunze / Unsplash
Four-image grid, row by row: FLUX.1-dev, Stable Diffusion 3.5 medium, Stable Diffusion XL, Stable Diffusion 1.5