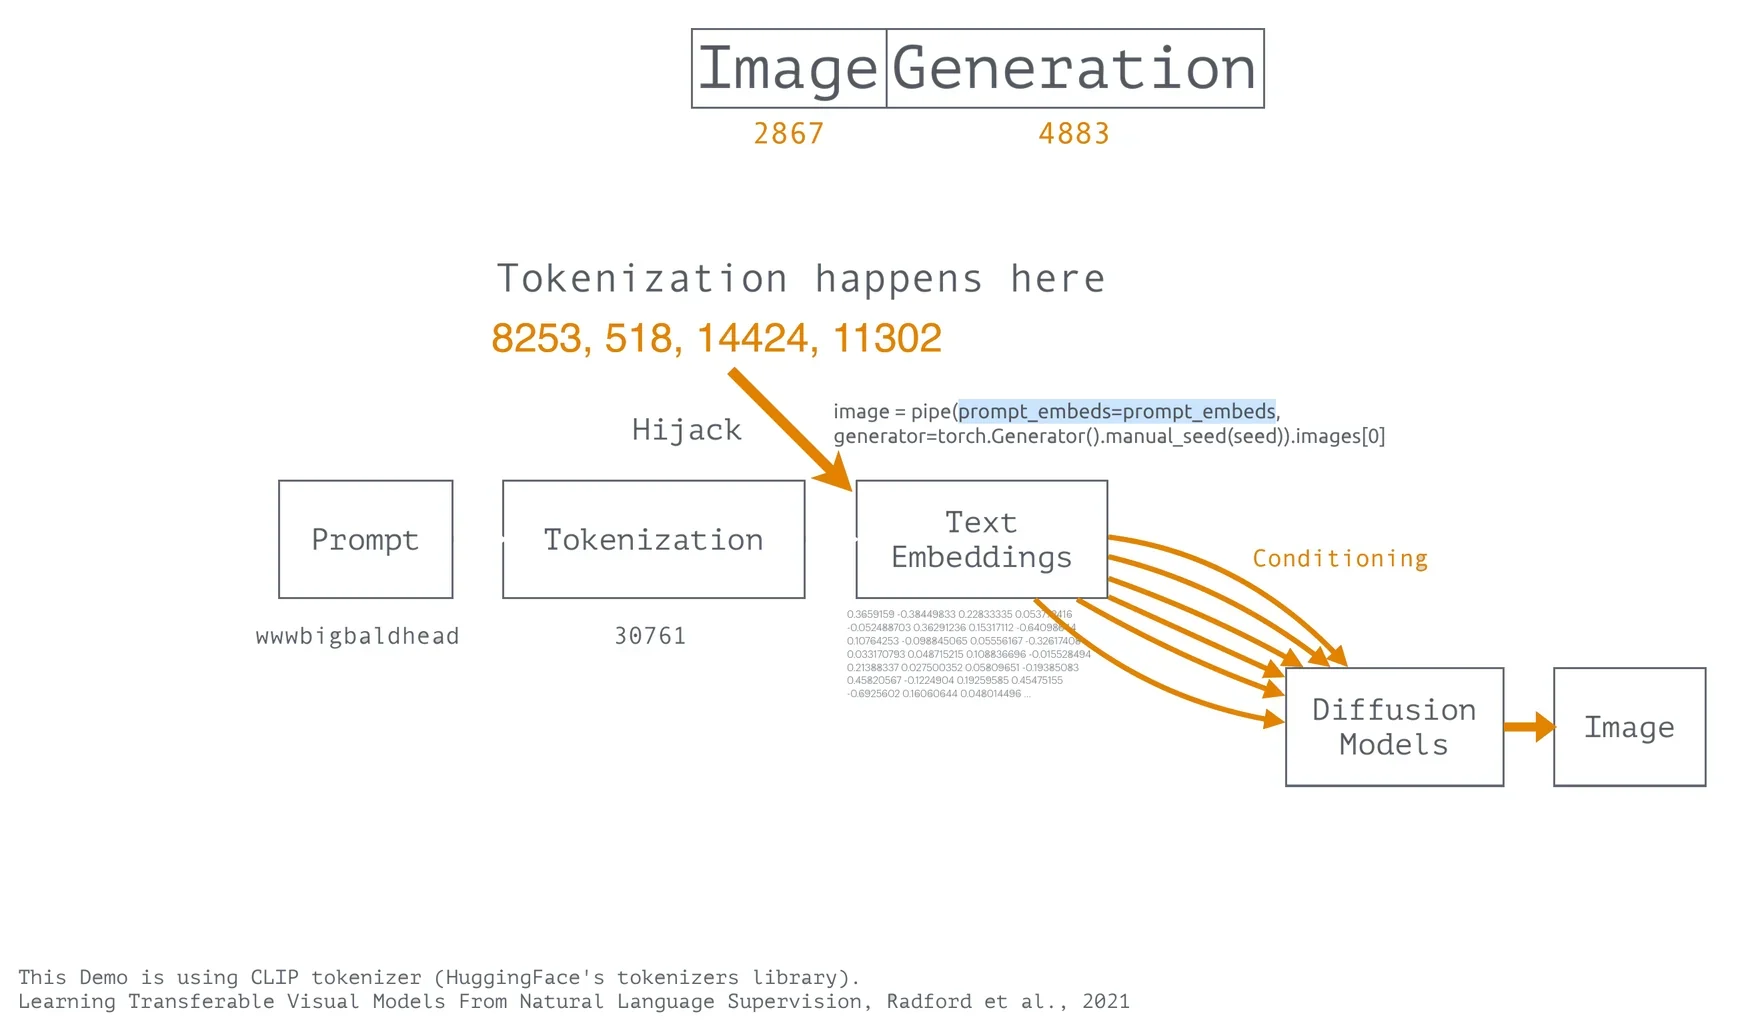
Bildgeneratoren lesen keine Wörter. Dazwischen steht ein multimodales Foundation-Modell wie CLIP, trainiert mit Hunderten Millionen Bildern und ihren Bildunterschriften. Es hat zwei Encoder, einen Vision Transformer für Bilder und einen Text-Transformer für Sprache, und legt beide in einen gemeinsamen Raum, in dem sich ein Bild und ein Satz als Abstand vergleichen lassen. Viele Text-zu-Bild-Modelle verwenden den Text-Encoder von CLIP, um zu steuern, was sie zeichnen.
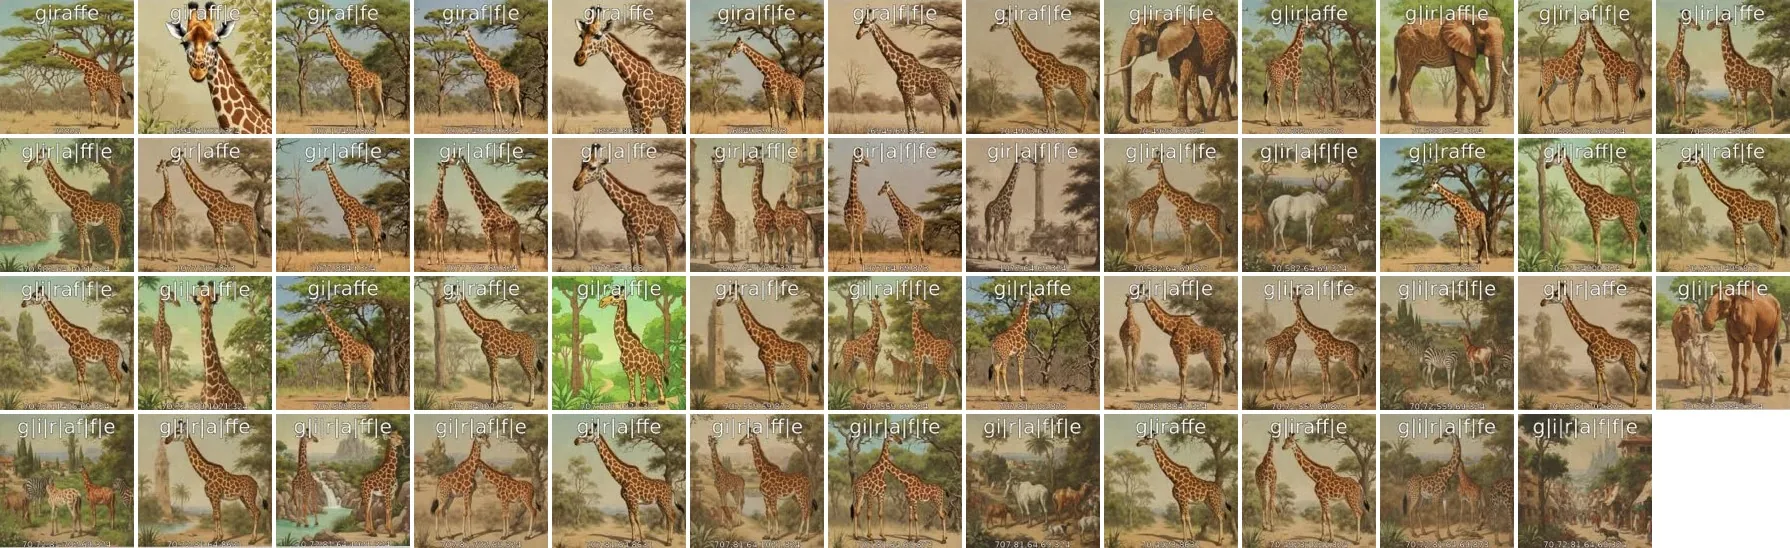
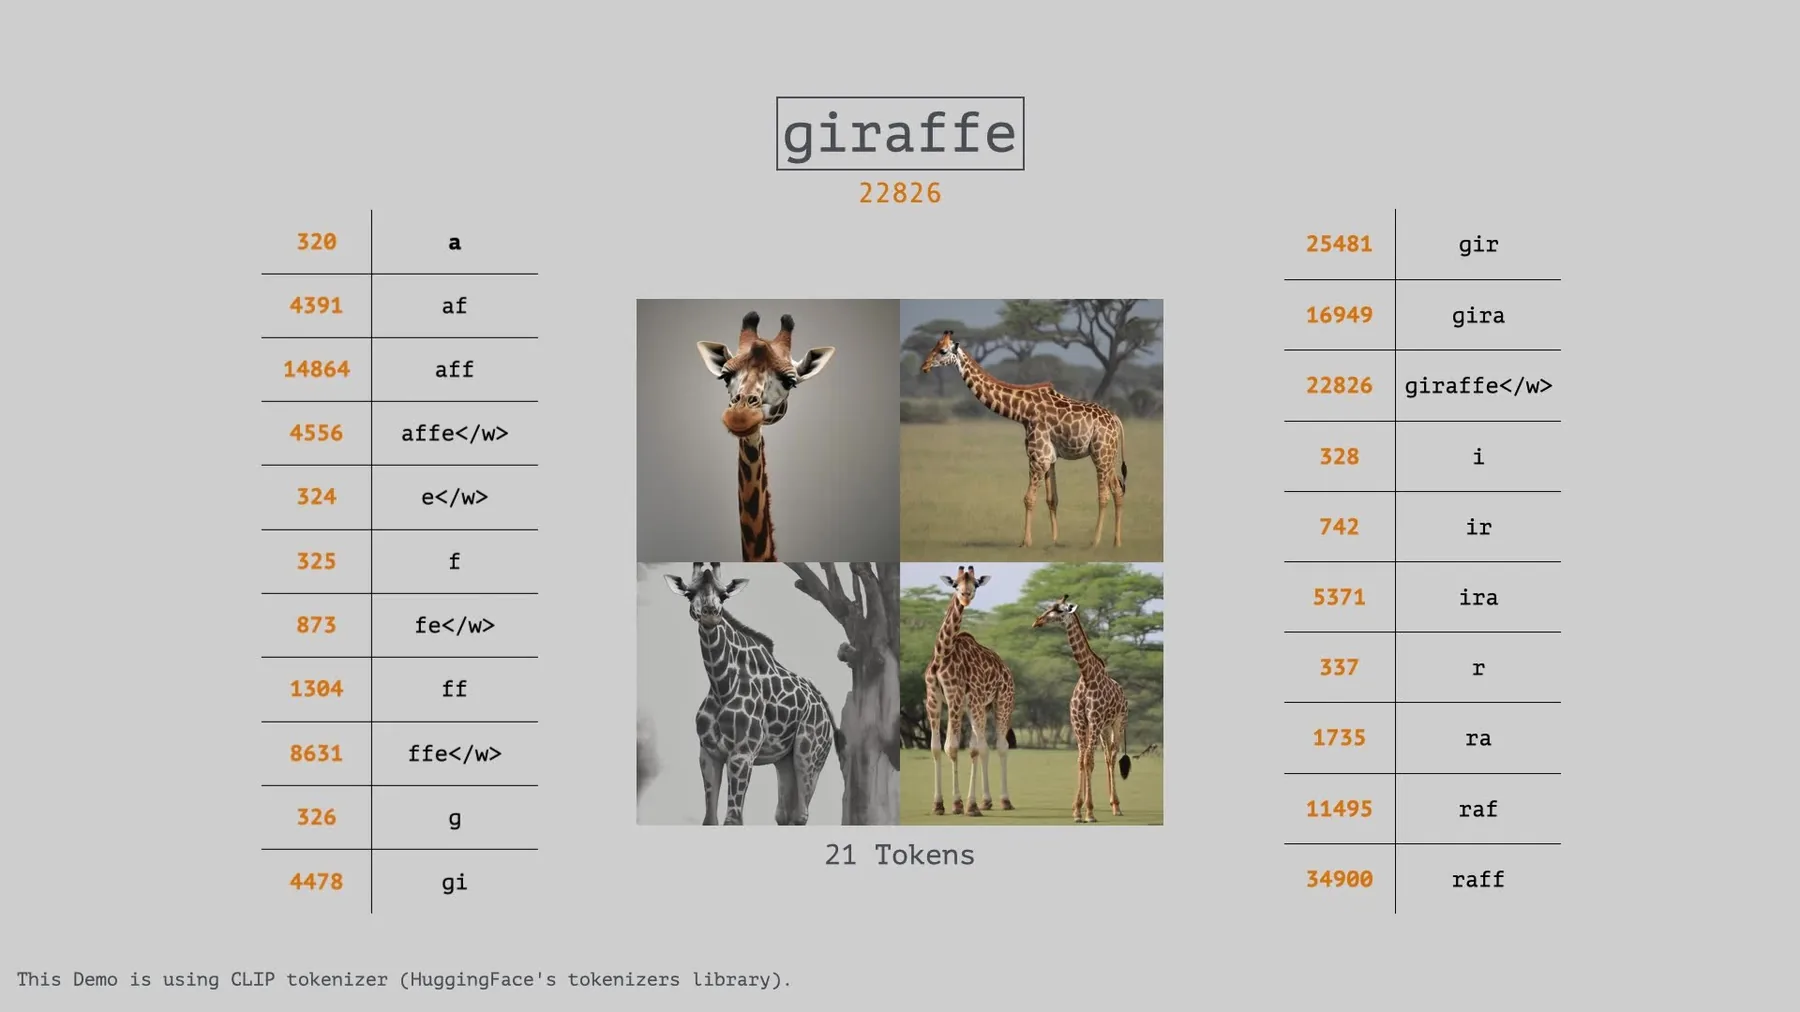
Bevor dieser Encoder einen Prompt liest, zerlegt ein Tokenizer die Wörter in Token: Stücke aus einem festen Wörterbuch mit rund 49.000 Einträgen. „giraffe“ ist eines davon, doch dasselbe Wort lässt sich auch aus kleineren Stücken zusammensetzen, auf 51 verschiedene Arten, von giraffe in einem Stück bis zu g|i|r|a|f|f|e Buchstabe für Buchstabe.
Der Eingriff
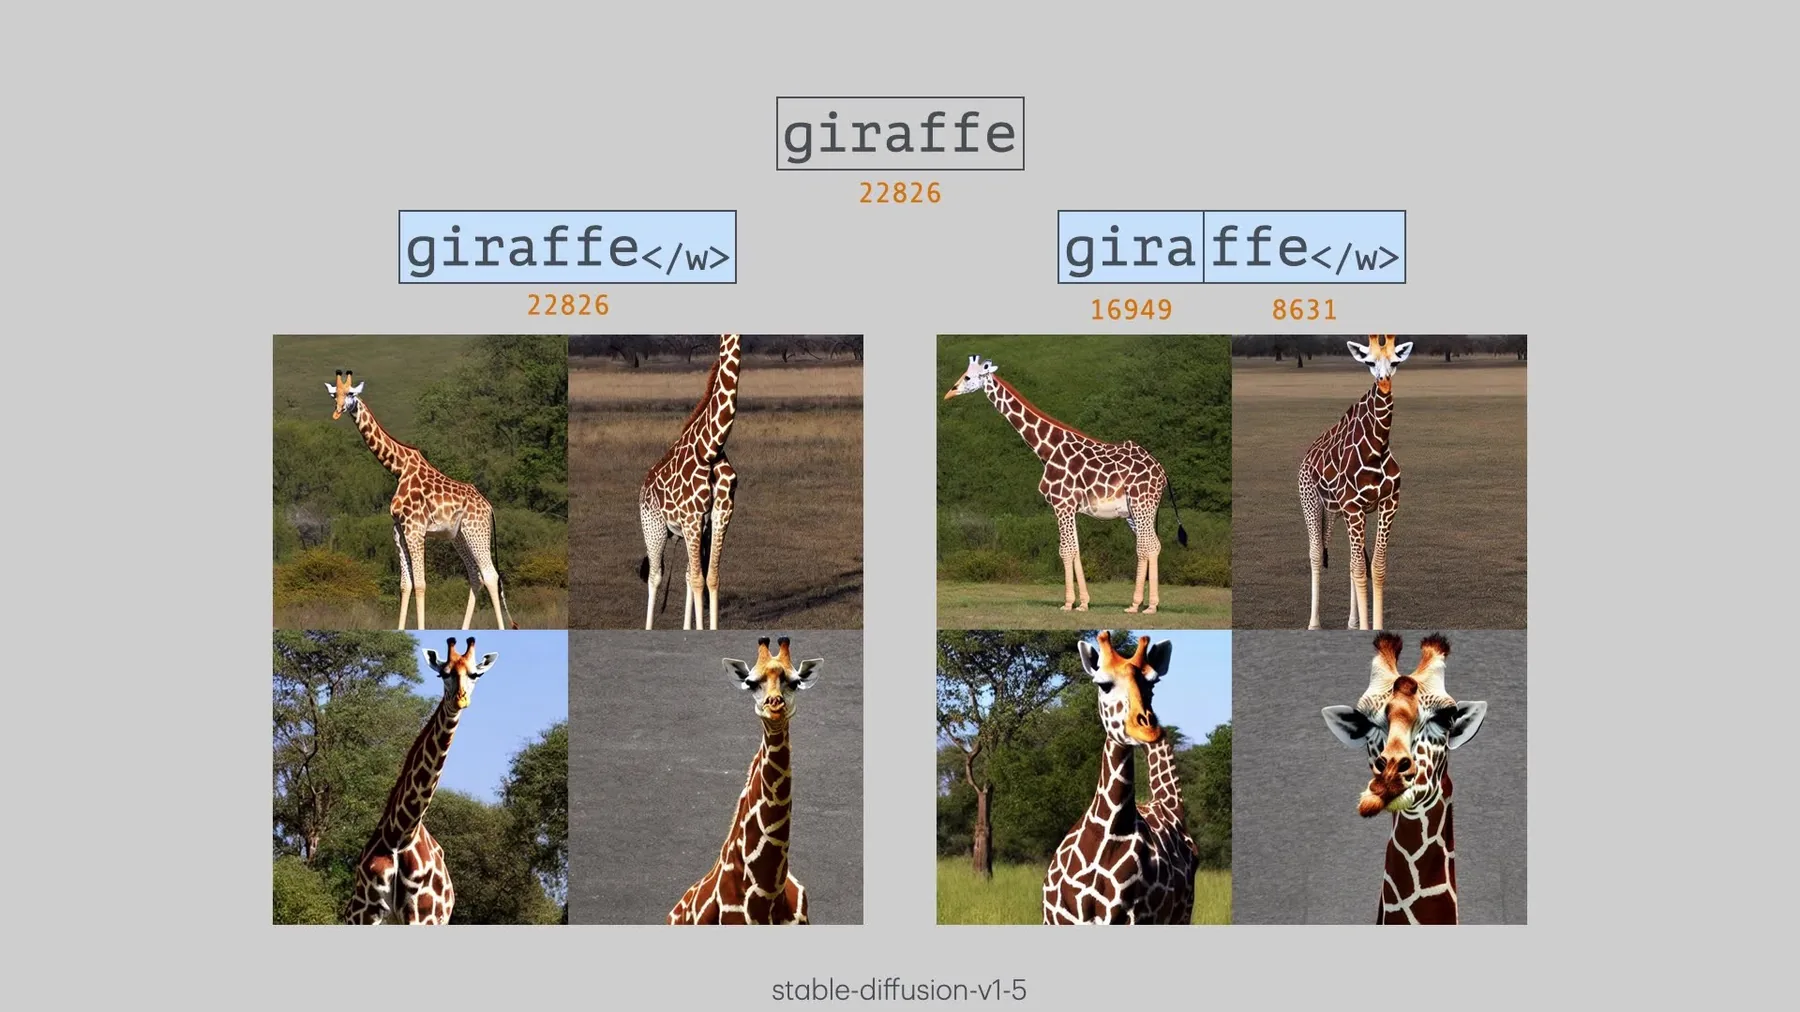
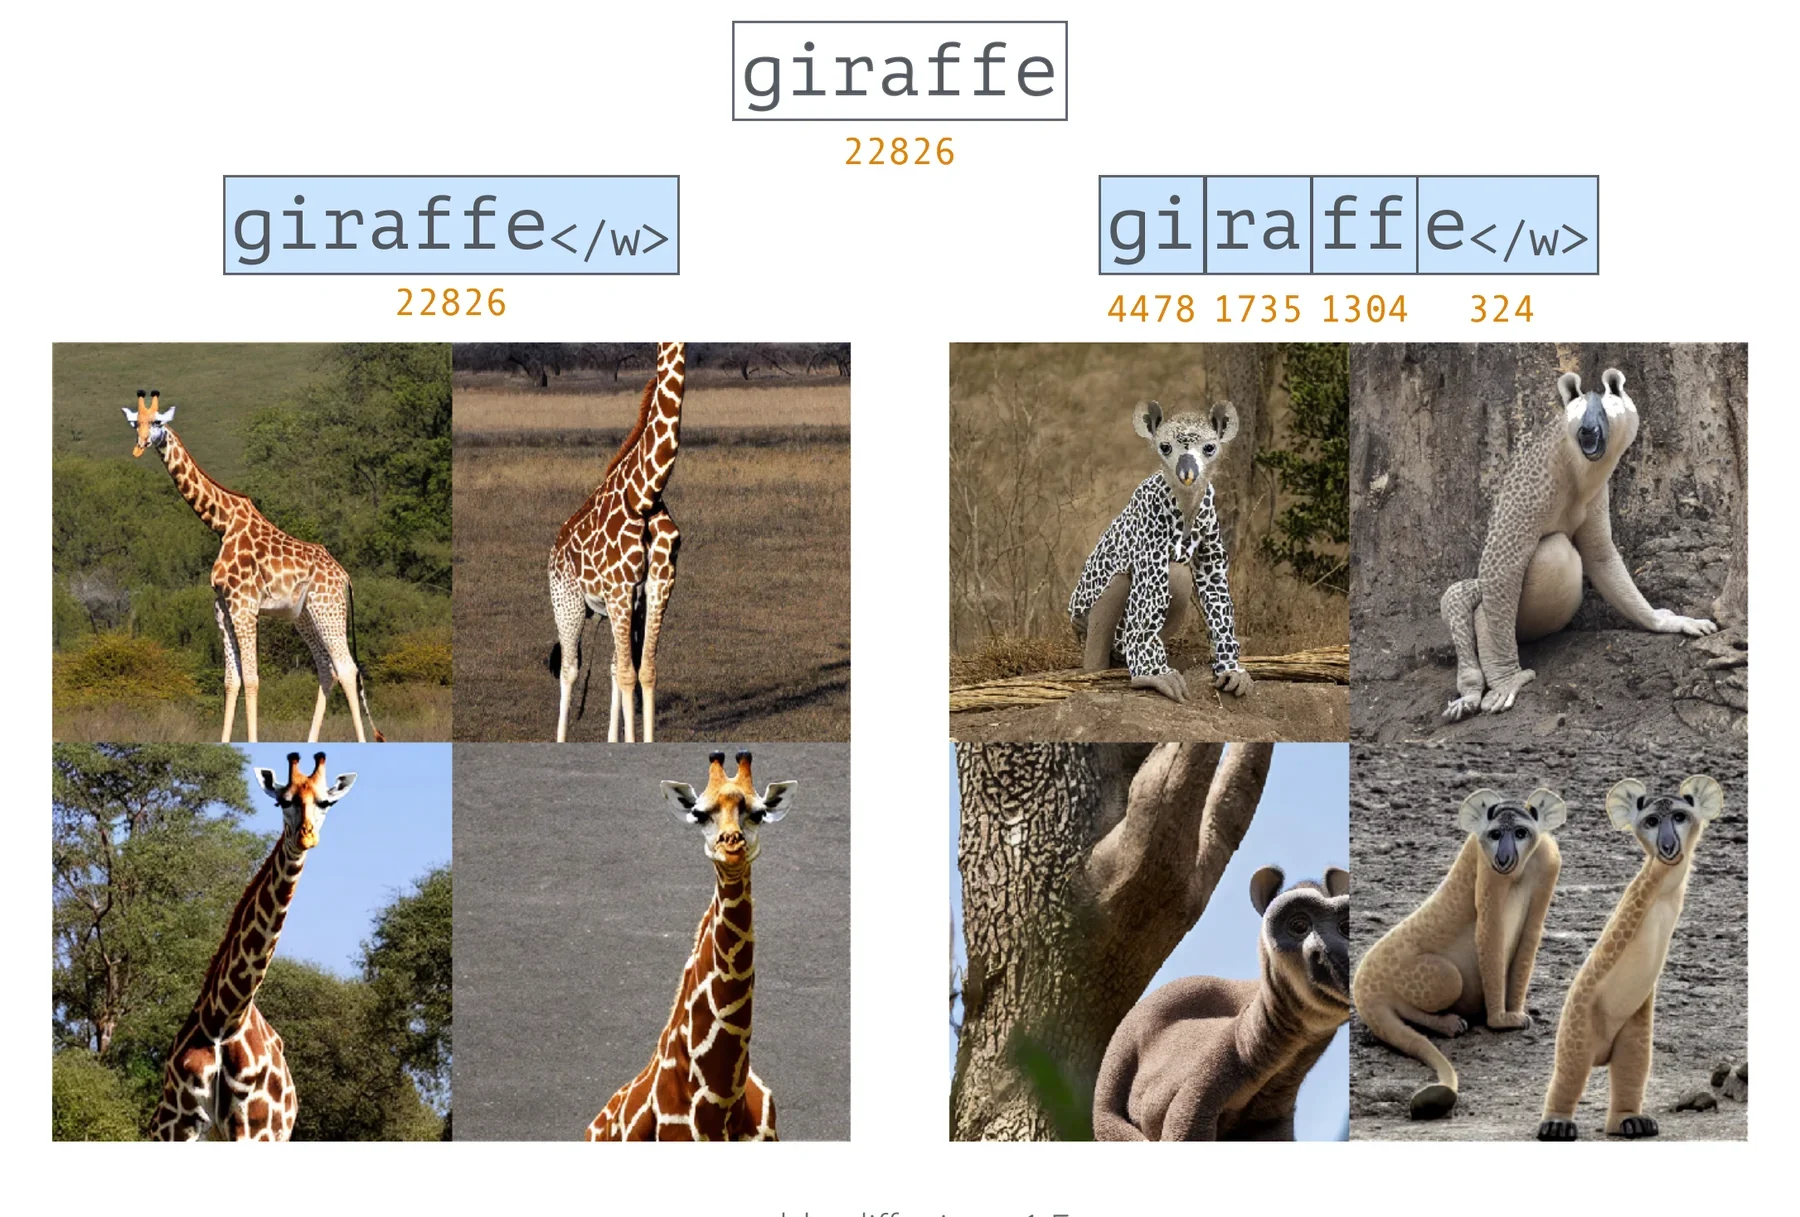
Normalerweise wählt niemand diese Schreibweisen: Wer „giraffe“ in ein Prompt-Feld tippt, bekommt vom Tokenizer immer dieselbe Zerlegung. Wir haben eine Open-Source-Diffusionspipeline so verändert, dass sie diesen Schritt überspringt und Token-IDs direkt annimmt, die dem Text-Encoder als Embeddings übergeben werden. Liegt der Schnitt in unserer Hand, wird jede Schreibweise zu einem eigenen Prompt. Das Modell bekommt nie das Wort, sondern eine kurze Liste von Zahlen: giraffe als ein Token ist 22826; gira + ffe ist 16949, 8631; gi + ra + ff + e ist 4478, 1735, 1304, 324.
Die meisten Schreibweisen ergeben weiterhin eine Giraffe: ein Token oder gira|ffe sehen fast gleich aus. In gi|ra|ff|e zerlegt, entstehen gefleckte Wesen irgendwo zwischen Lemur und Hund; andere Schreibweisen driften zu einem Elefanten oder einem Pferd. Was erscheint, hängt nicht nur davon ab, was wir schreiben, sondern davon, wie das Wörterbuch es zerschneidet.
Das Wörterbuch
Das Wörterbuch ist nicht neutral. Es entsteht durch Byte Pair Encoding: Die Zeichenpaare, die in aus dem Netz gesammeltem Text am häufigsten vorkommen, werden immer wieder zu neuen Token verschmolzen. Markennamen, Plattform-Slang und Hashtags werden zu einzelnen Token, seltenere und nicht englische Wörter zerfallen in lange Ketten von Fragmenten. Manche Wörter wurden gezielt entfernt, sodass sich bestimmte Bilder gar nicht anfordern lassen. All das ist entschieden, bevor das Modell ein einziges Bild gesehen hat.
Die Forschung liest diese verborgene Schicht als eigene Sprache: für wen sie geschrieben wurde, was sie auslässt und was sie durchlässt.
Vortrag
51 Ways to Spell the Image Giraffe: The Hidden Politics of Token Languages in Generative AI, 39. Chaos Communication Congress (39C3), Hamburg, Dezember 2025, mit Leon-Etienne Kühr. Die Aufzeichnung ist auf media.ccc.de.
Die verwandte Arbeit Sixteen Tokens for a Cave schreibt mit diesen Token, statt sie zu untersuchen.
Talk and research: Ting-Chun Liu, Leon-Etienne Kühr
Images: slides from the talk, 39C3, 2025; photograph of the speakers: still from the recording, media.ccc.de, CC BY 4.0