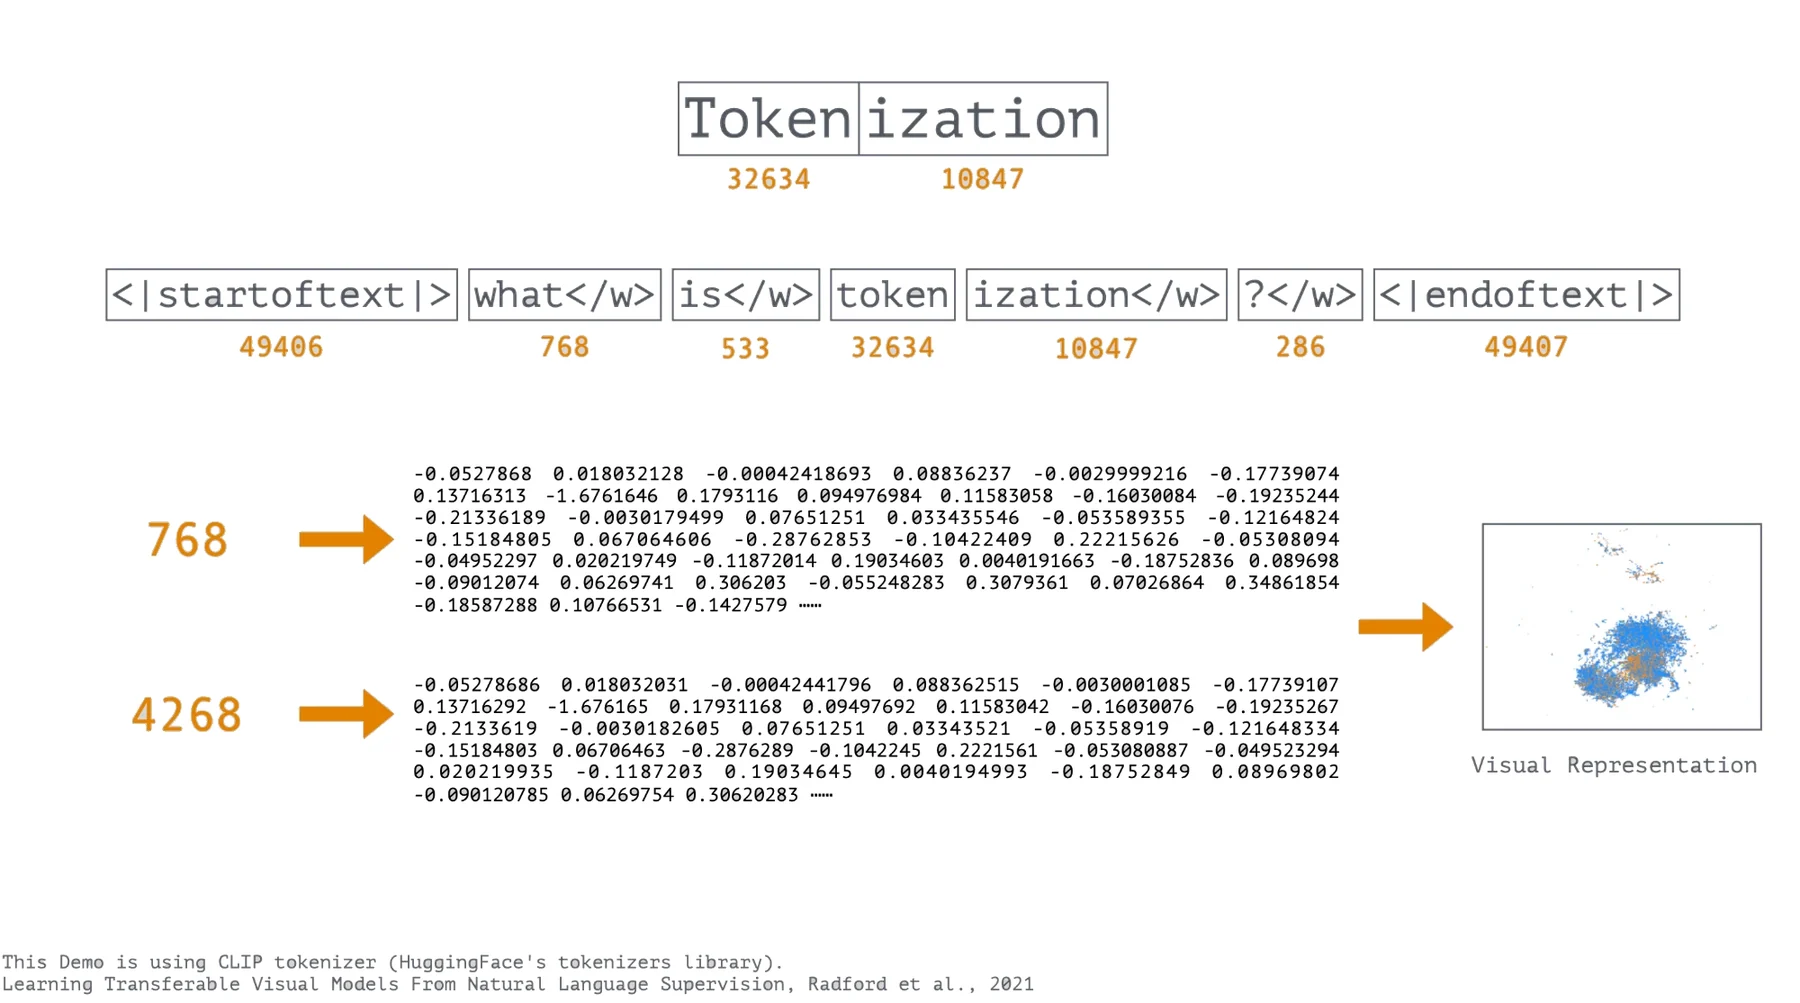
圖像生成器從來不讀提示詞裡的字。分詞器會先把字切成詞元(Token),也就是一本約 49,000 個條目的固定字典裡的碎片,模型只收到它們的編號:「what is tokenization?」送進去時是 49406、768、533、32634、10847、286、49407。每個編號再對應到一串 768 個數值的嵌入向量(Embedding),真正進到模型裡的只有這串數值。
這個工作坊延續在 39C3 發表的講座《51 Ways to Spell the Image Giraffe》,用一套在瀏覽器裡操作的小工具打開這一層。不需要寫程式的經驗。
什麼是詞元
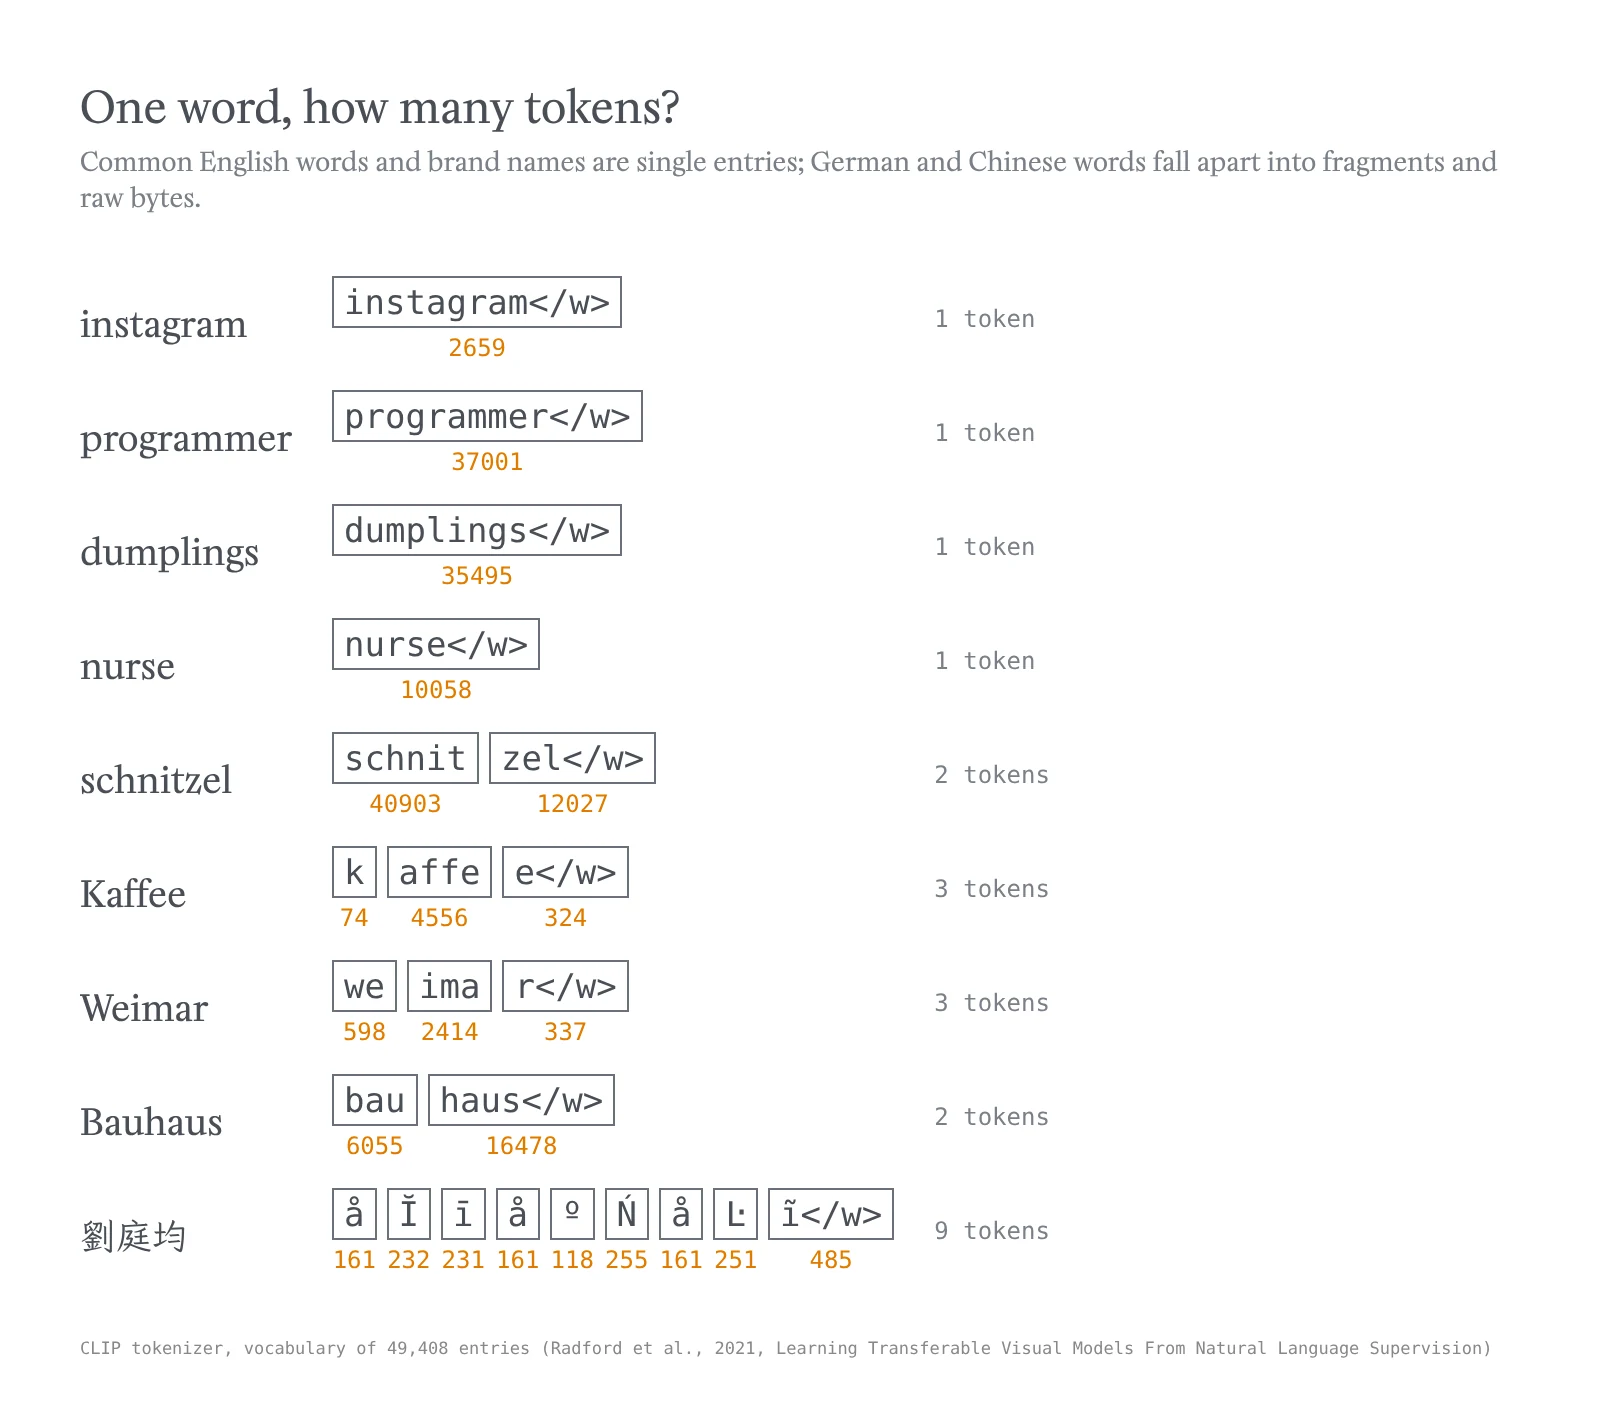
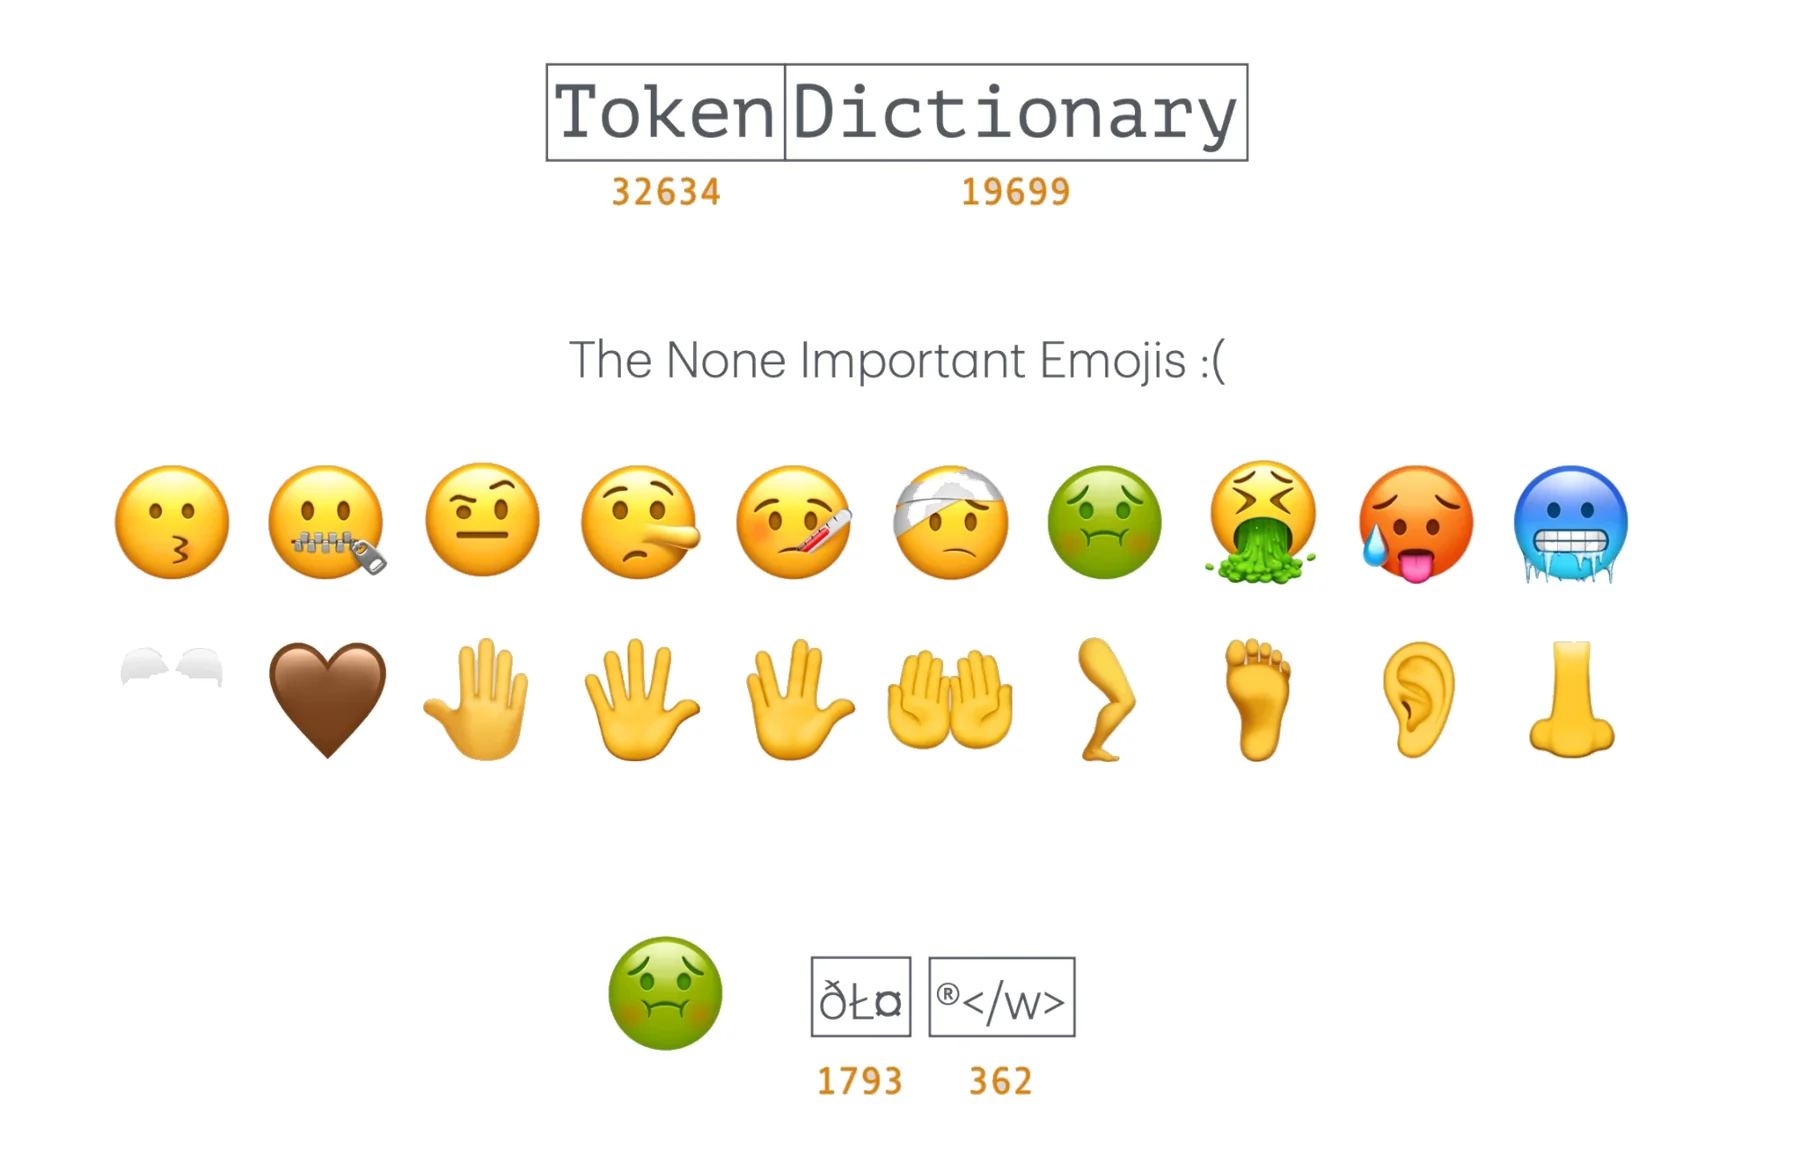
參與者輸入句子,看它們被拆開。常見的英文字、品牌名稱和主題標籤都是單一條目;「schnitzel(炸肉排)」要兩塊,「Kaffee(咖啡)」要三塊,一個中文名字則被拆成九個原始位元組。許多表情符號也沒有自己的條目,同樣由位元組碎片拼成。這本字典是為誰寫的,從每種語言要付出多少詞元就看得出來。
詞元字典
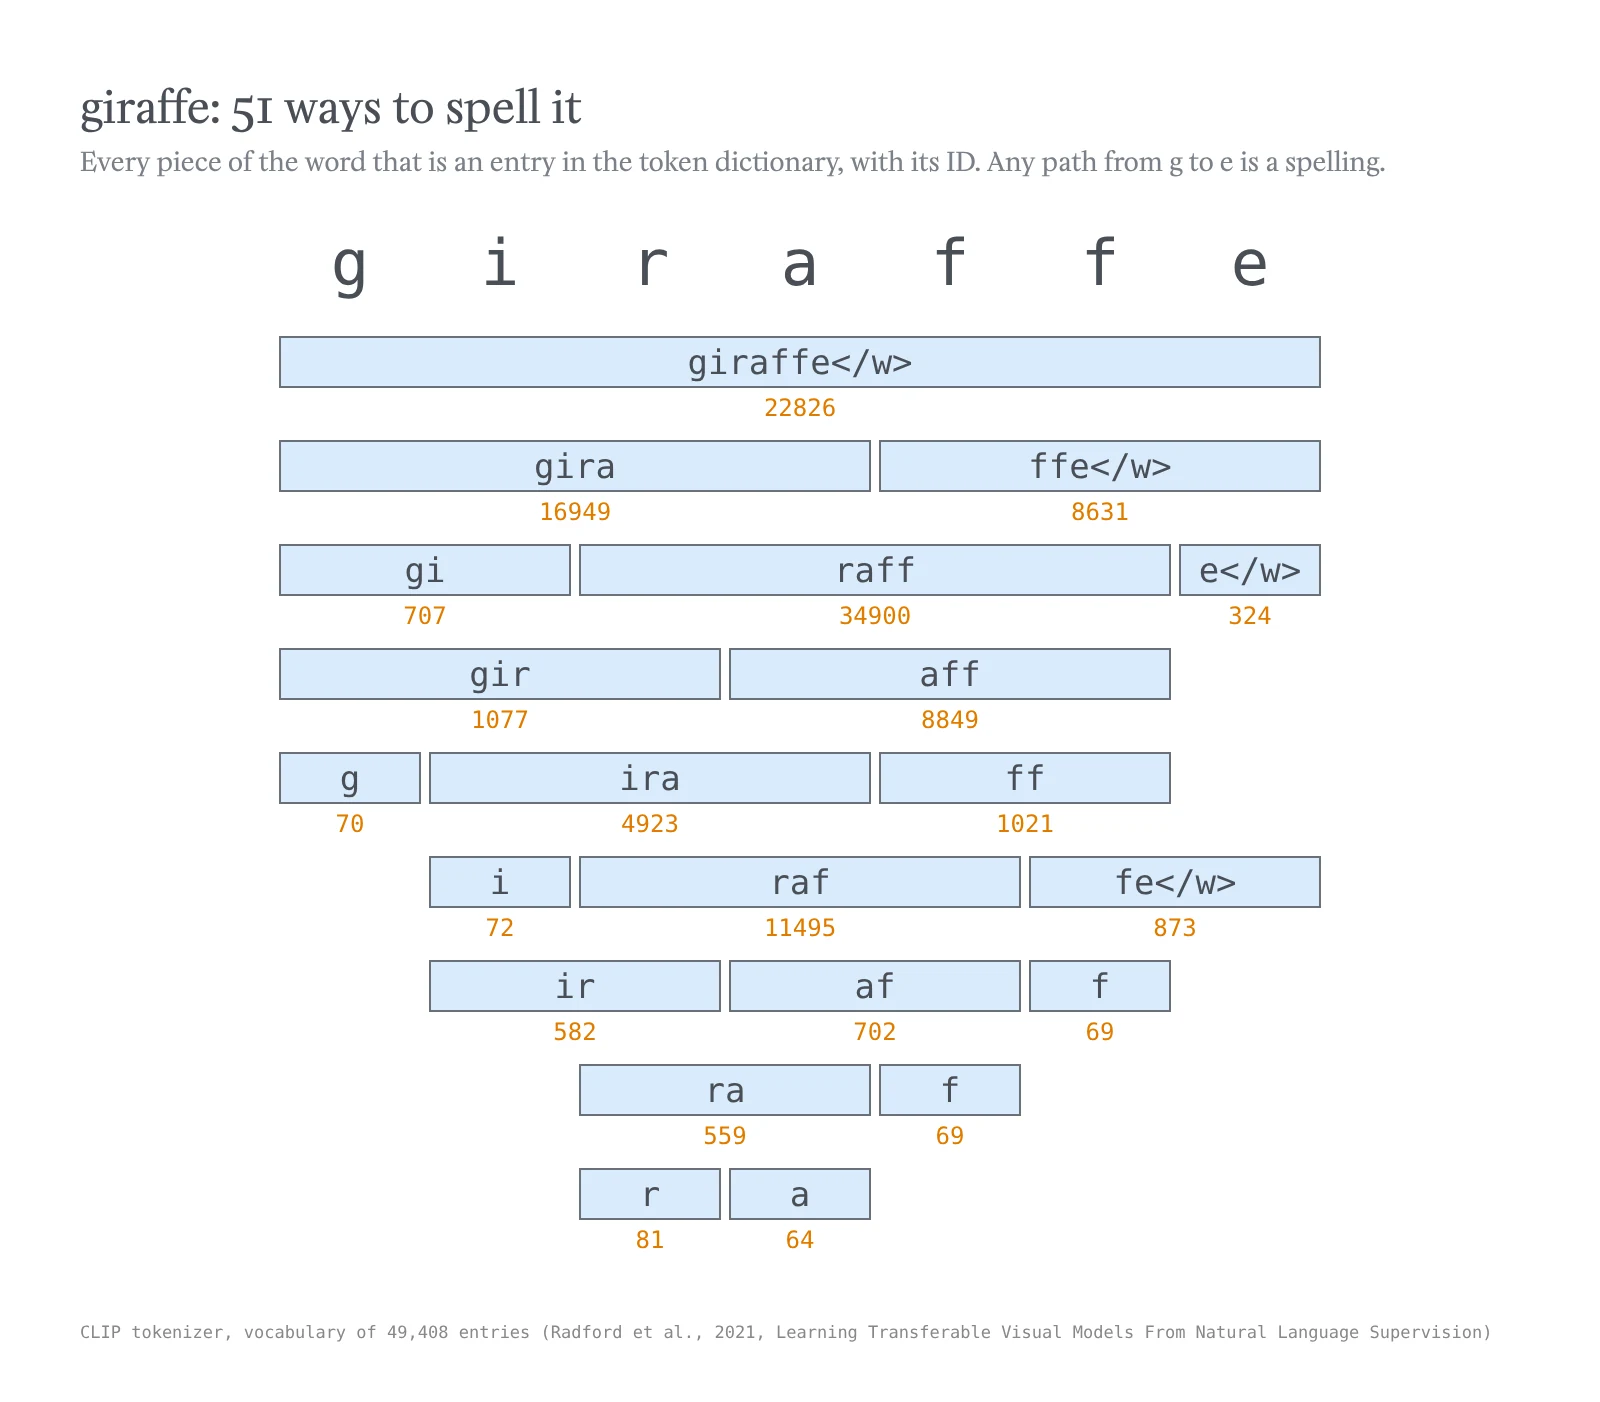
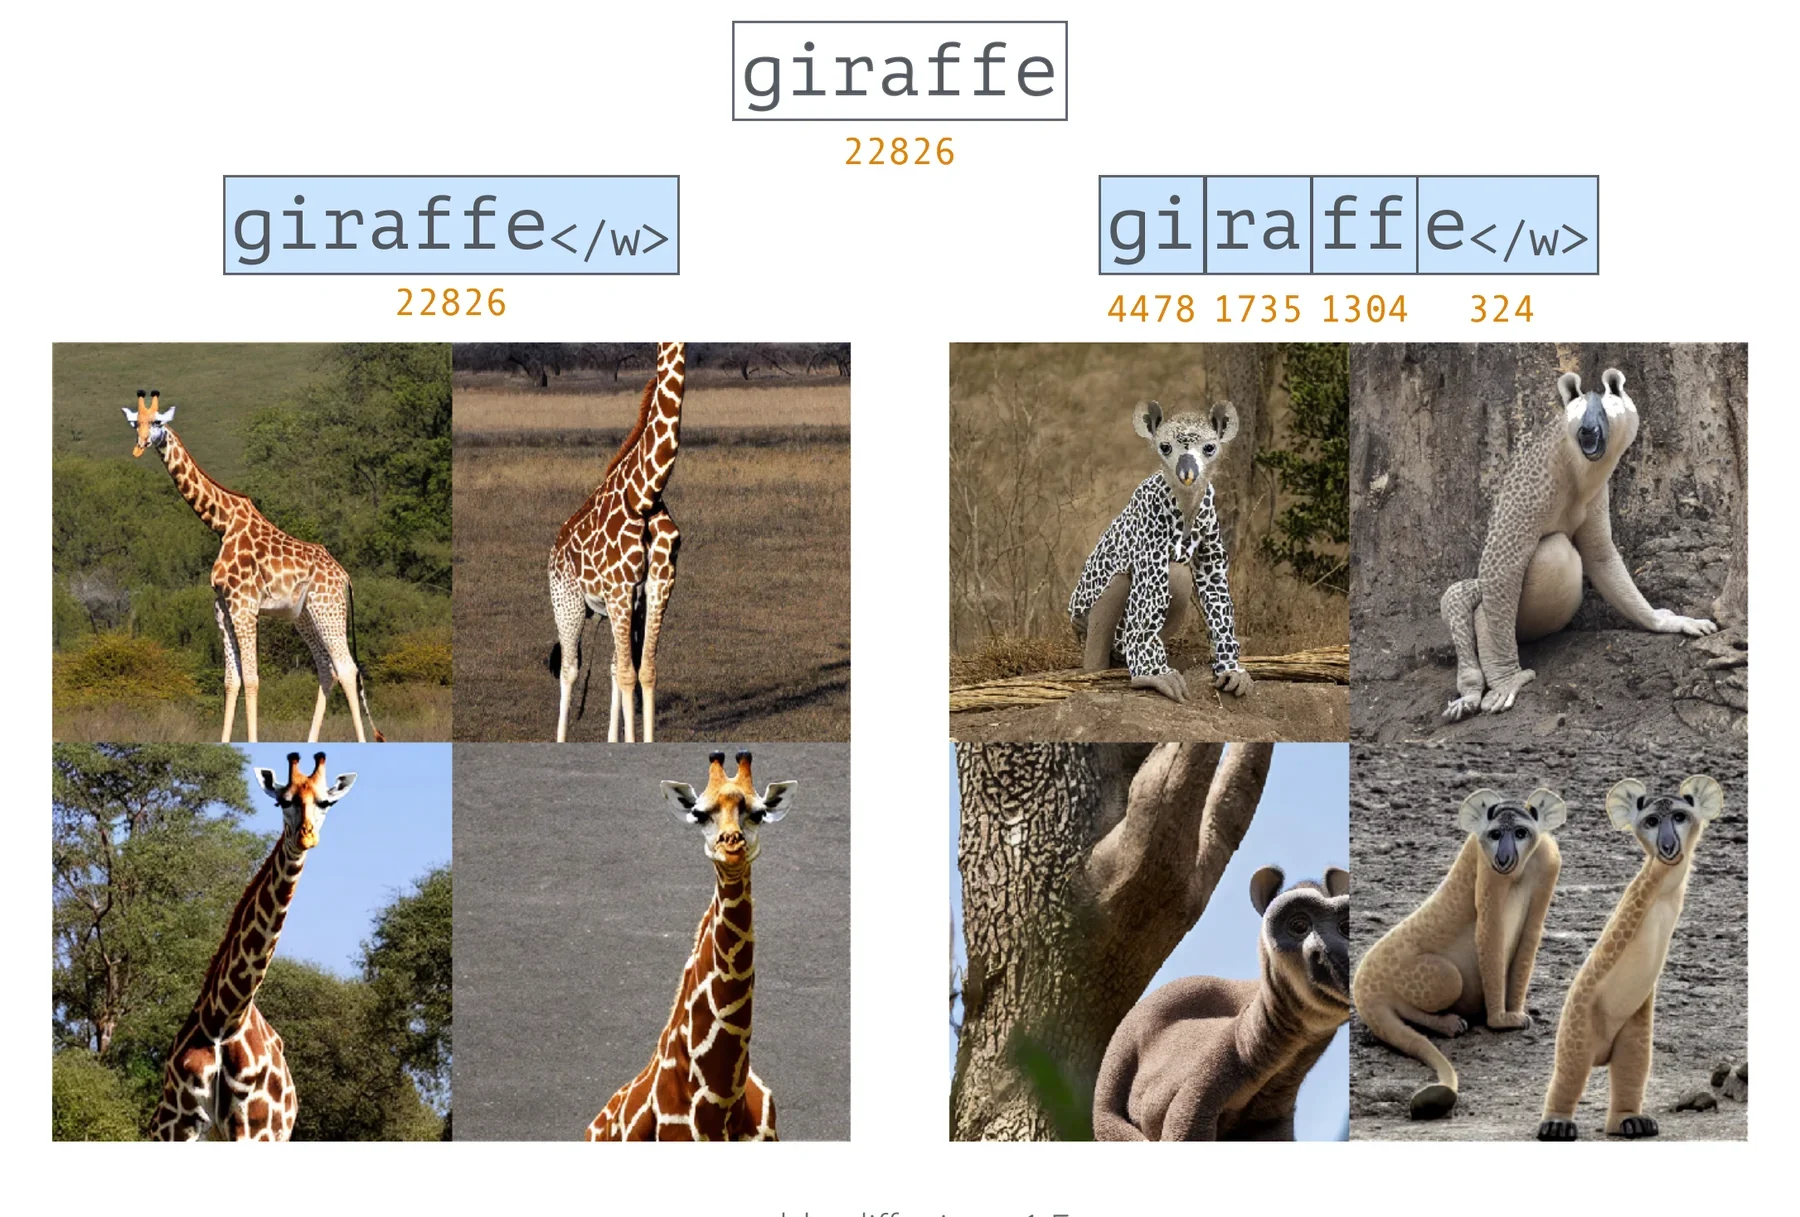
整本字典都能搜尋。「giraffe」裡藏著許多本身就是條目的碎片,從 gira、ffe 一直到單一字母,能拼出 51 種不同的組合。平常分詞器永遠只選同一種。
用數字寫提示詞
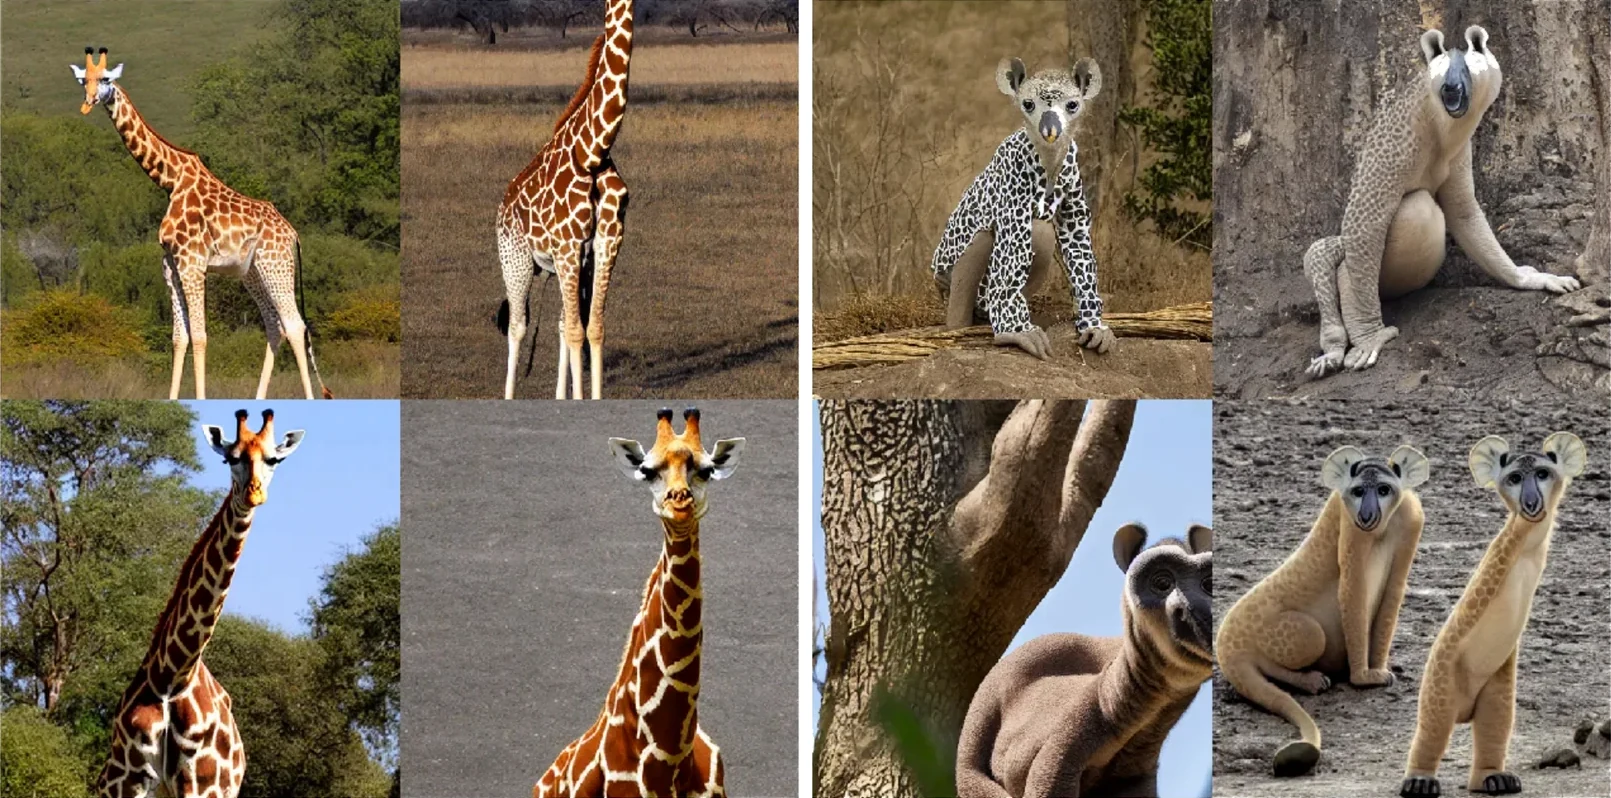
工作坊使用一個改寫過的圖像生成器(SDXL Turbo),讓它直接接收詞元編號。參與者跳過分詞器,自己決定怎麼切:一整個 giraffe、gira + ffe,或 gi + ra + ff + e,每一種都是一個獨立的提示詞。多數拼法仍然畫出長頸鹿,有些卻畫出世上不存在的動物。
重建一張圖
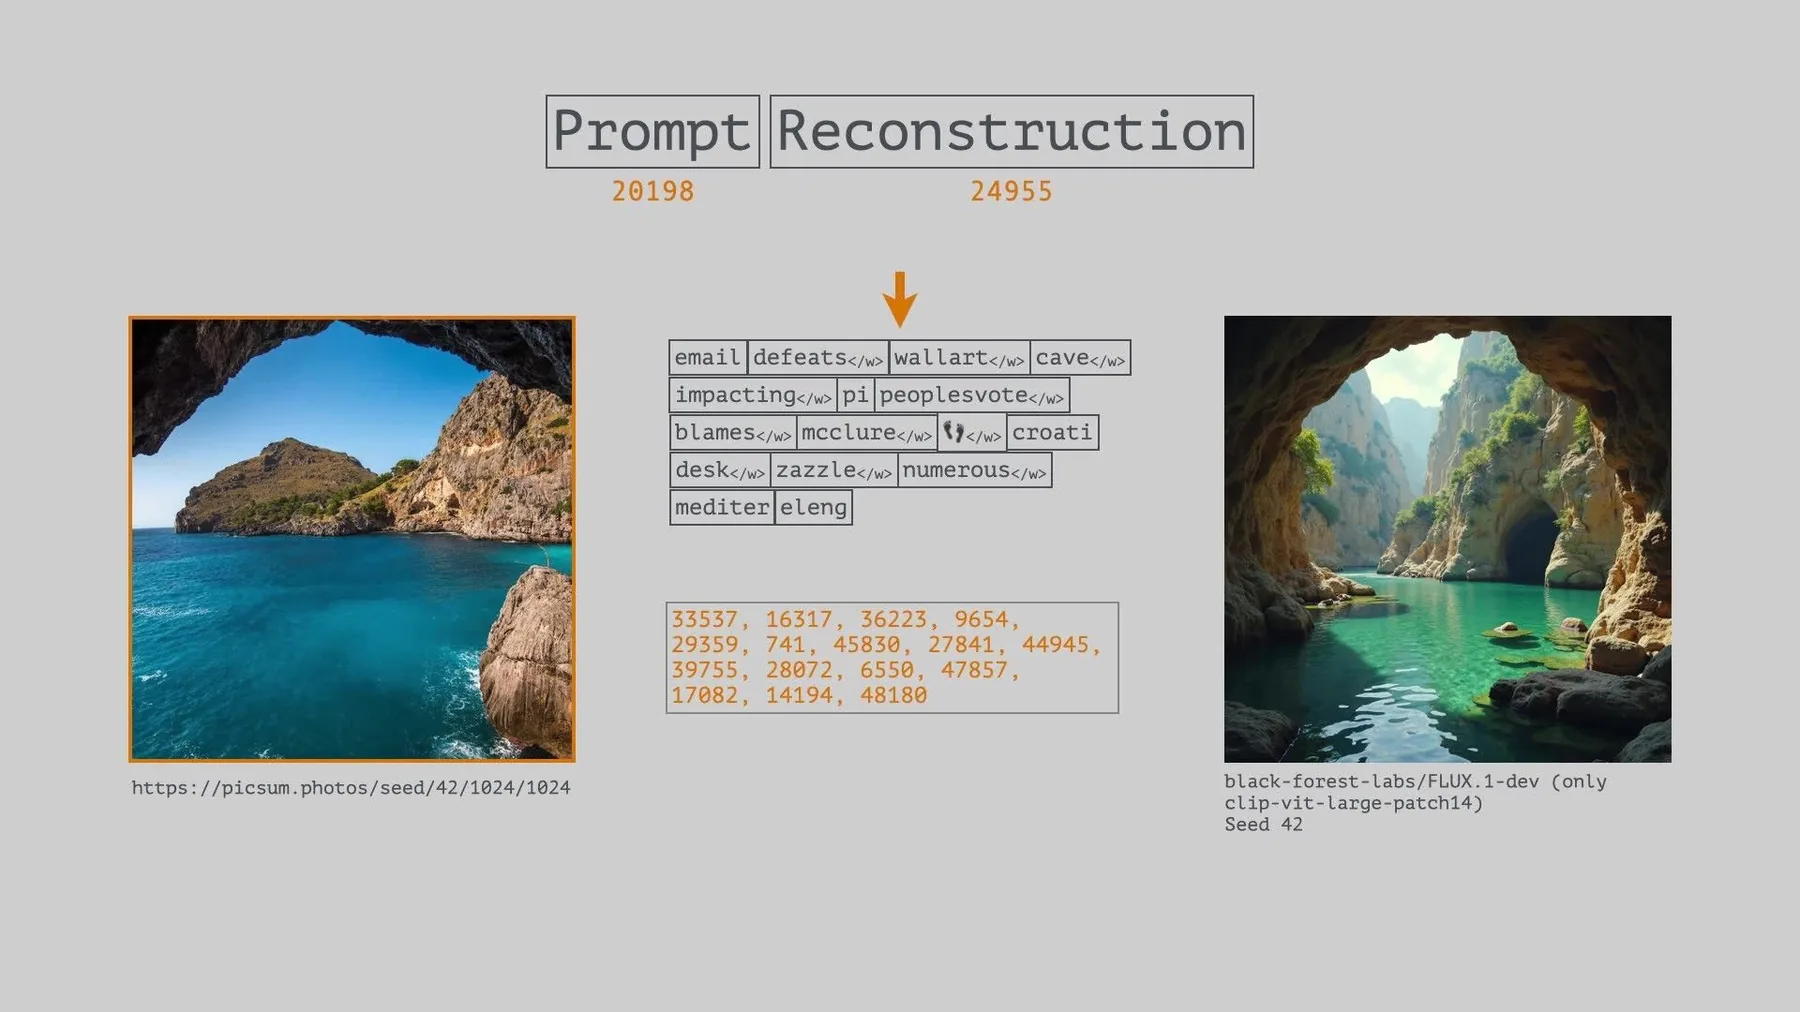
最後一個練習反過來做:從一張照片出發,用遺傳演算法培育 16 個詞元長的序列,直到 CLIP 認為它們和照片夠接近。結果讀起來像雜訊,圖像生成器卻能從中把照片畫回來。畫出來的東西,顯示了機器留下了什麼,又有什麼是它從來沒有字可以說的。