工作坊的起點是一個疑問:為什麼生成器會生出這一張圖?為了找答案,研究從 CLIP,以及 CLIP Interrogator 這類能從圖片反推提示詞的工具開始。
CLIP 會把圖片和文字放進同一個空間,再用一個分數表示兩者有多相符。許多圖像生成器和圖片搜尋工具,都靠它判斷「這張圖是不是符合這段描述」,只是使用者通常看不到這個步驟。
配對
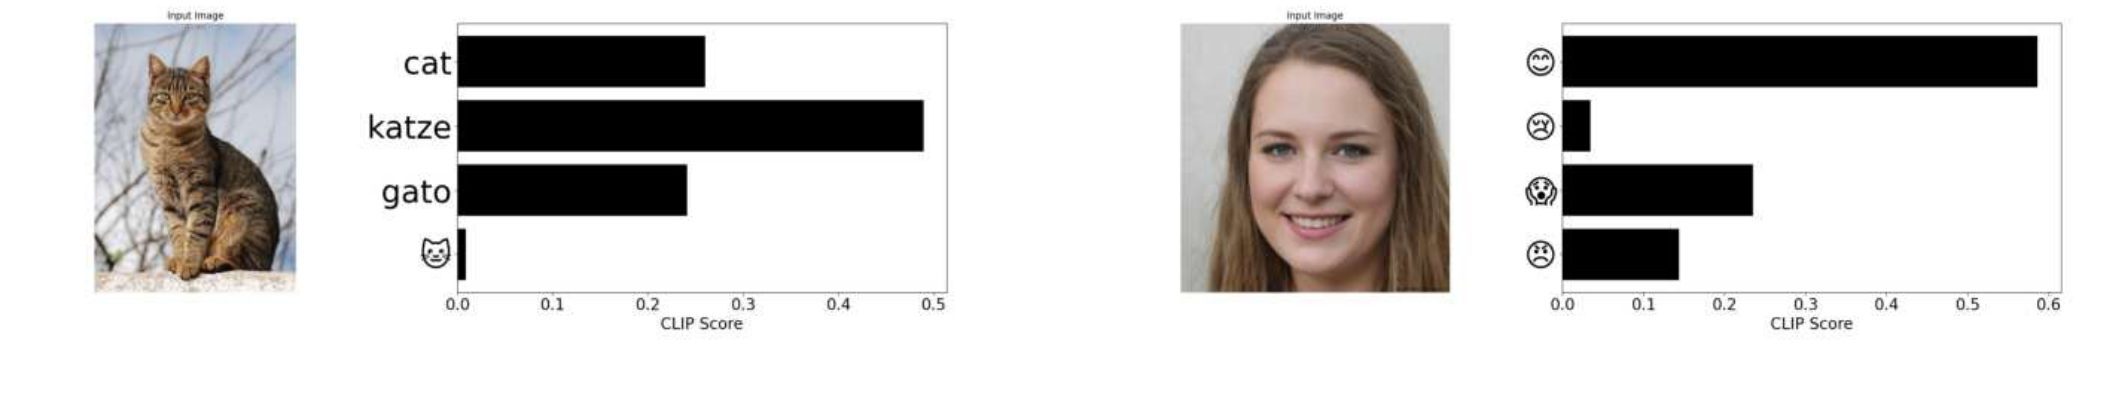
參與者給 CLIP 一張圖和幾段短文字,看它覺得哪一段最貼切:馬格利特(René Magritte)畫的那支煙斗,對上「this is a pipe」和「this isn’t a pipe」;一張貓的照片,對上英文「cat」、德文「Katze」和西班牙文「gato」;一張人工智慧生成的人臉,對上四個不同表情的表情符號。分數幾乎從來不是中立的,而這些出乎意料的結果,正是這個練習想讓大家看到的。
搜尋
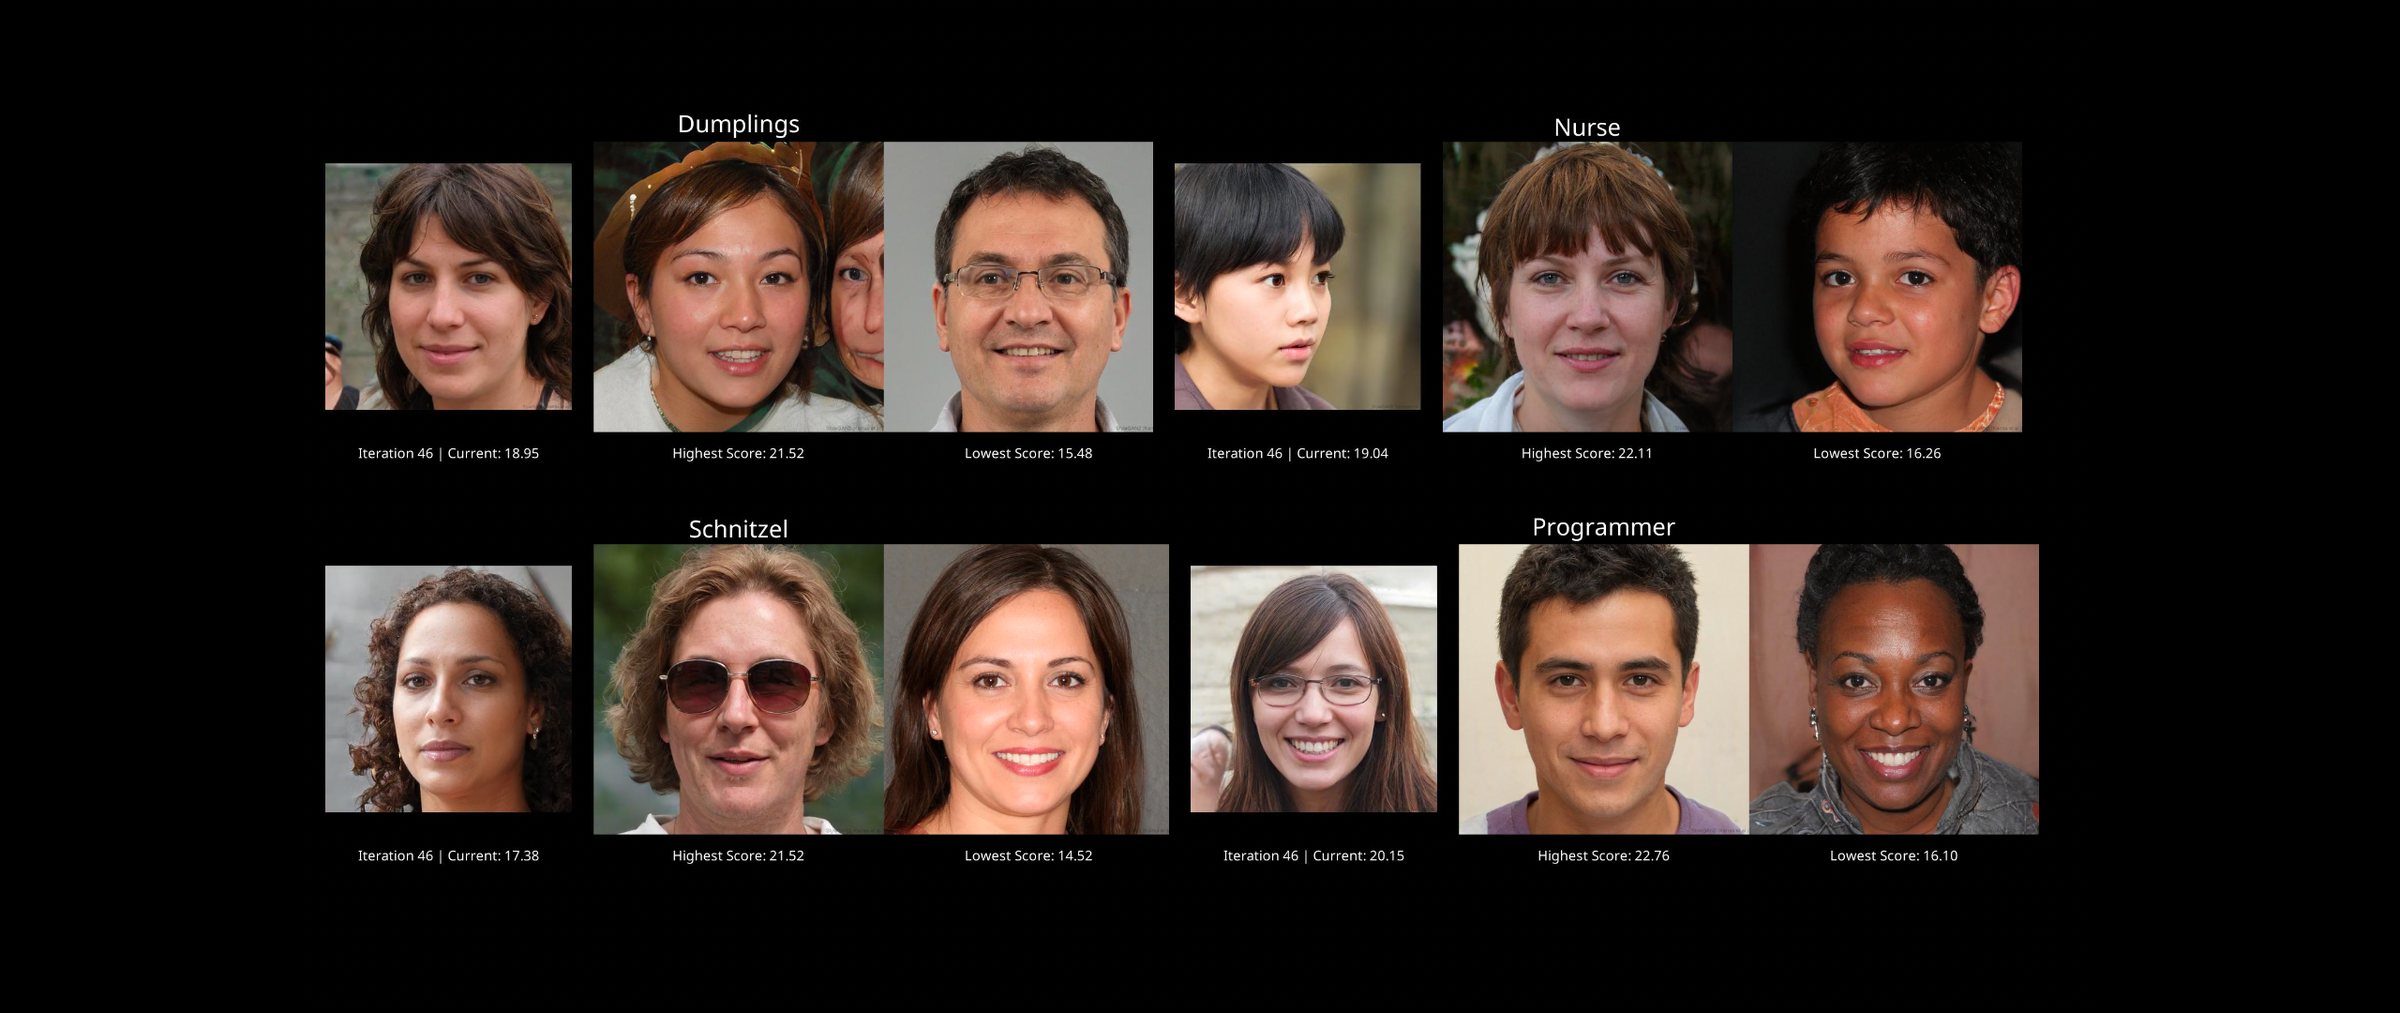
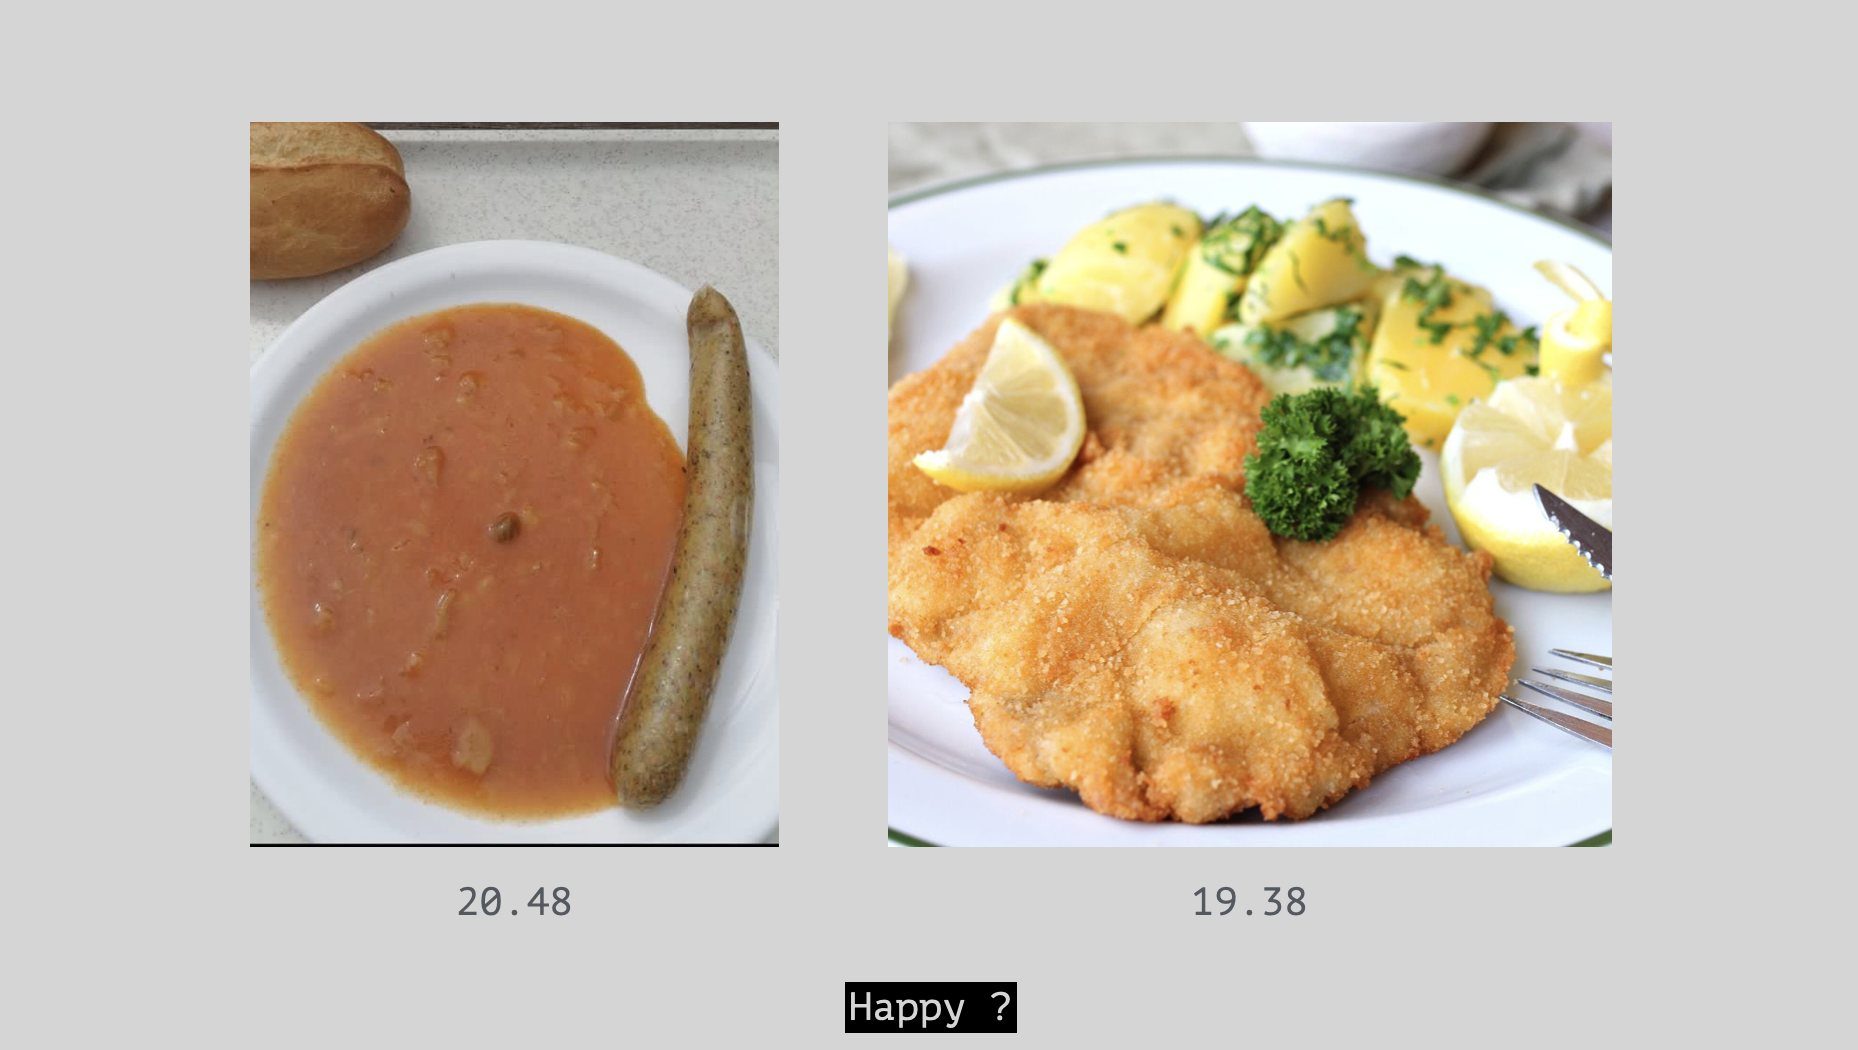
接著反過來,讓 CLIP 去找圖。程式不斷從一個專門生成「不存在的人」的網站抓取隨機人臉,每一張都拿去跟一個詞(例如「happy」)比對打分,只留下目前分數最高和最低的那兩張。把詞換成「nurse(護理師)」、「programmer(程式設計師)」或「dumplings(餃子)」再跑一次,機器對這些詞的刻板印象就會一點一點浮現。拿食物來試也一樣奇怪:有一輪測「happy」,一盤配香腸的湯拿到 20.48 分,比一盤金黃的炸肉排(19.38 分)還高。