Das multimodale Modell CLIP verstehen, das beurteilt, ob ein Bild zu einem Text passt. Während wir lernen, wie es Bilder bewertet, betrachten wir die Biases heutiger KI-Modelle gegenüber Bild und Text.
Am Anfang stand unsere eigene Frage: Warum kommt genau dieses Bild aus einem Generator? Die Suche nach einer Antwort führte uns zu CLIP und zu Werkzeugen wie dem CLIP Interrogator, der den Prompt hinter einem Bild errät.
CLIP legt Bilder und Texte in denselben Raum und gibt mit einem einzigen Wert an, wie gut sie zusammenpassen. Viele Bildgeneratoren und Bildsuchen entscheiden damit, ob ein Bild zu einer Beschreibung passt – ein Schritt, den ihre Nutzer*innen selten sehen.
Zuordnen
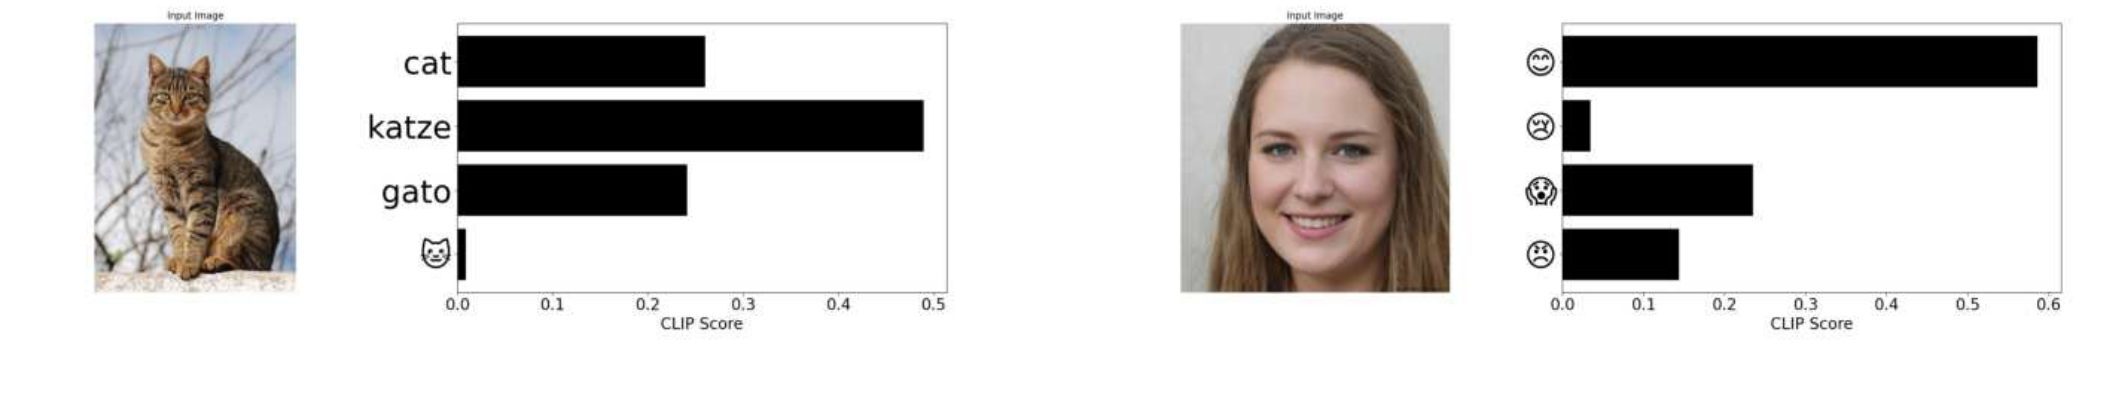
Die Teilnehmenden geben CLIP ein Bild und einige kurze Texte und sehen, welchen es für den passendsten hält: Magrittes Gemälde einer Pfeife gegen „this is a pipe“ und „this isn’t a pipe“; das Foto einer Katze gegen „cat“, „Katze“ und „gato“; ein KI-generiertes Gesicht gegen vier Emojis mit unterschiedlichem Ausdruck. Die Werte sind fast nie neutral, und genau um die Überraschungen geht es.
Suchen
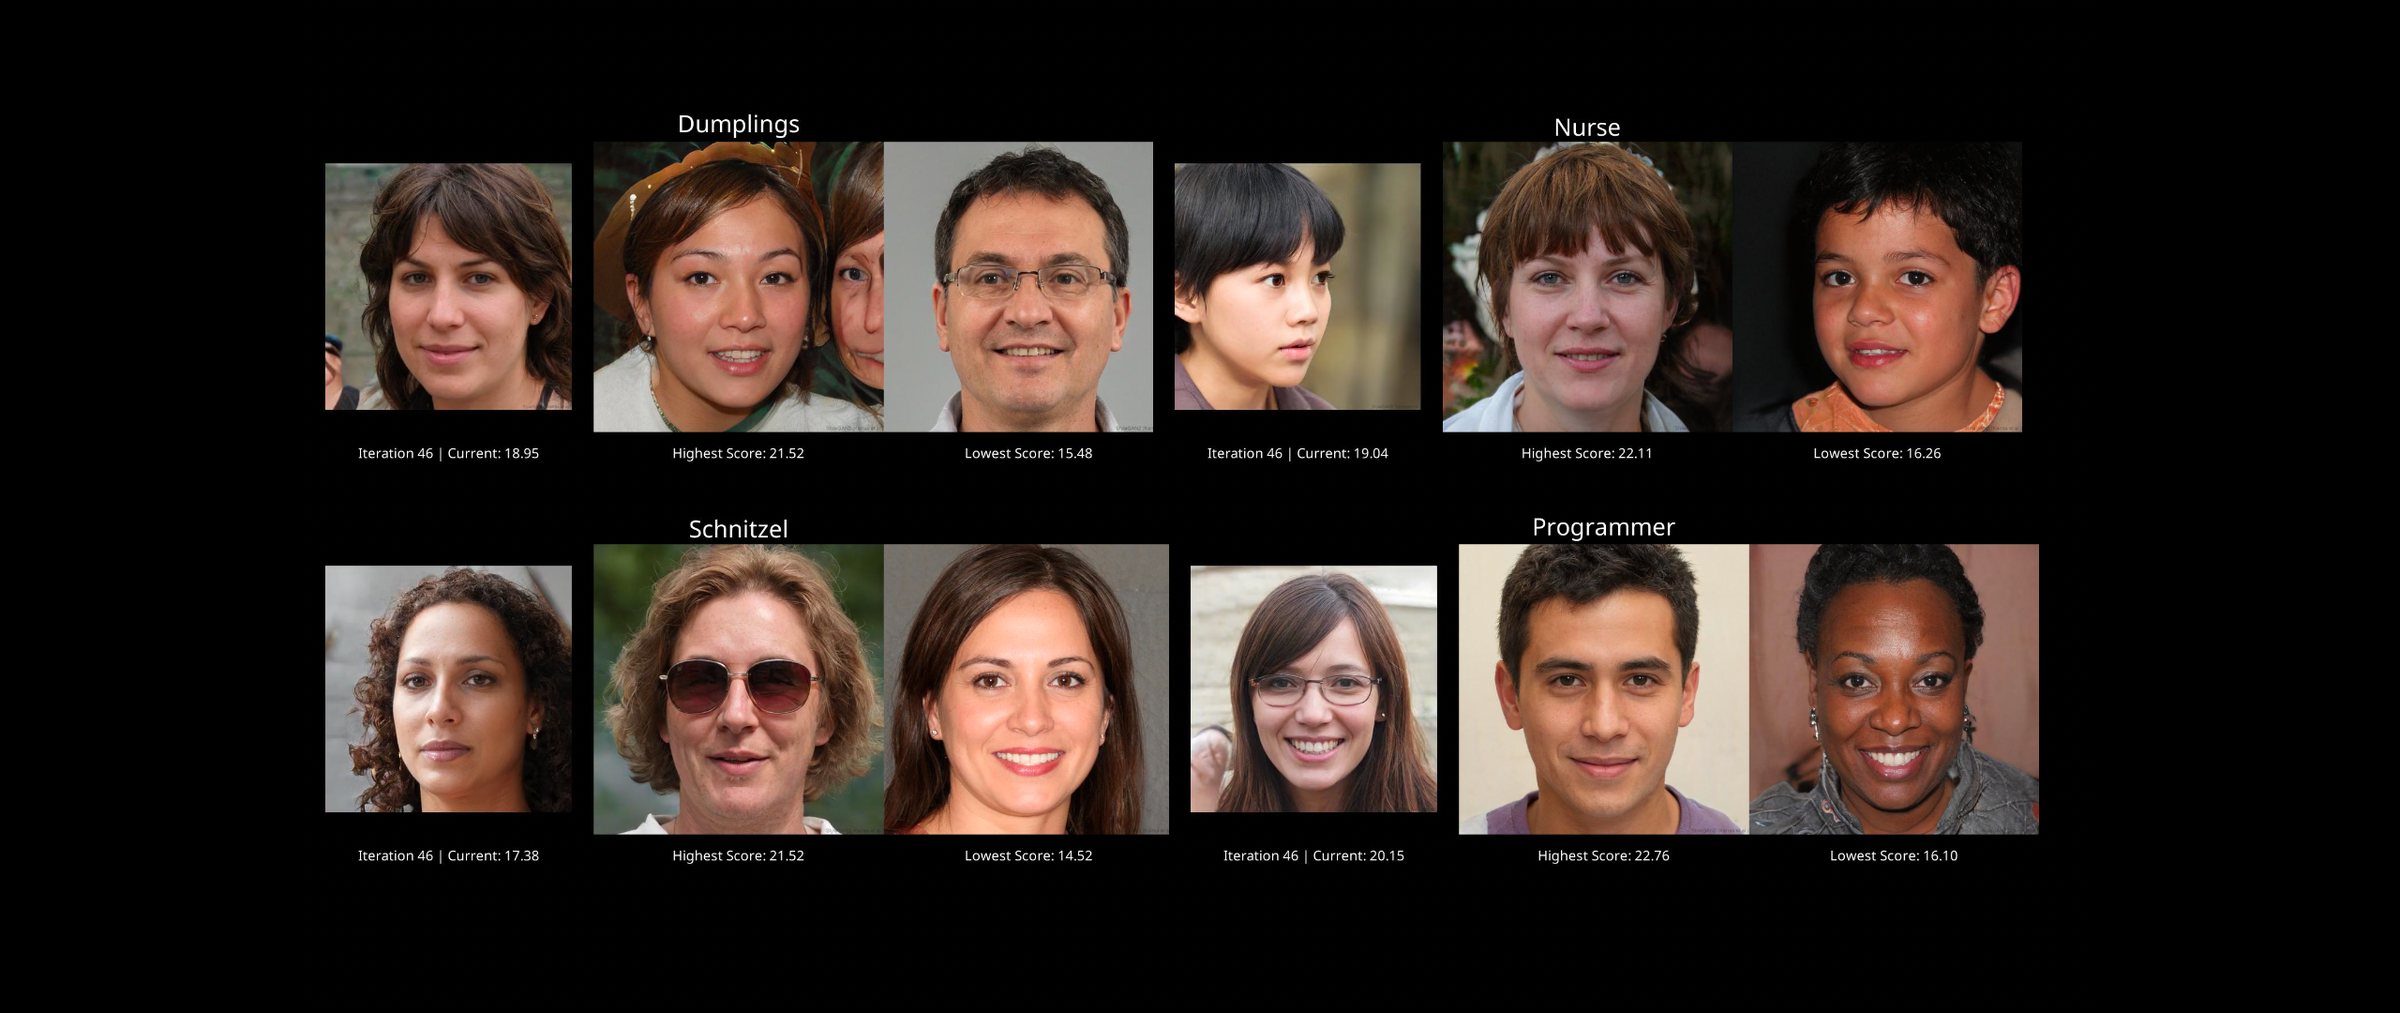
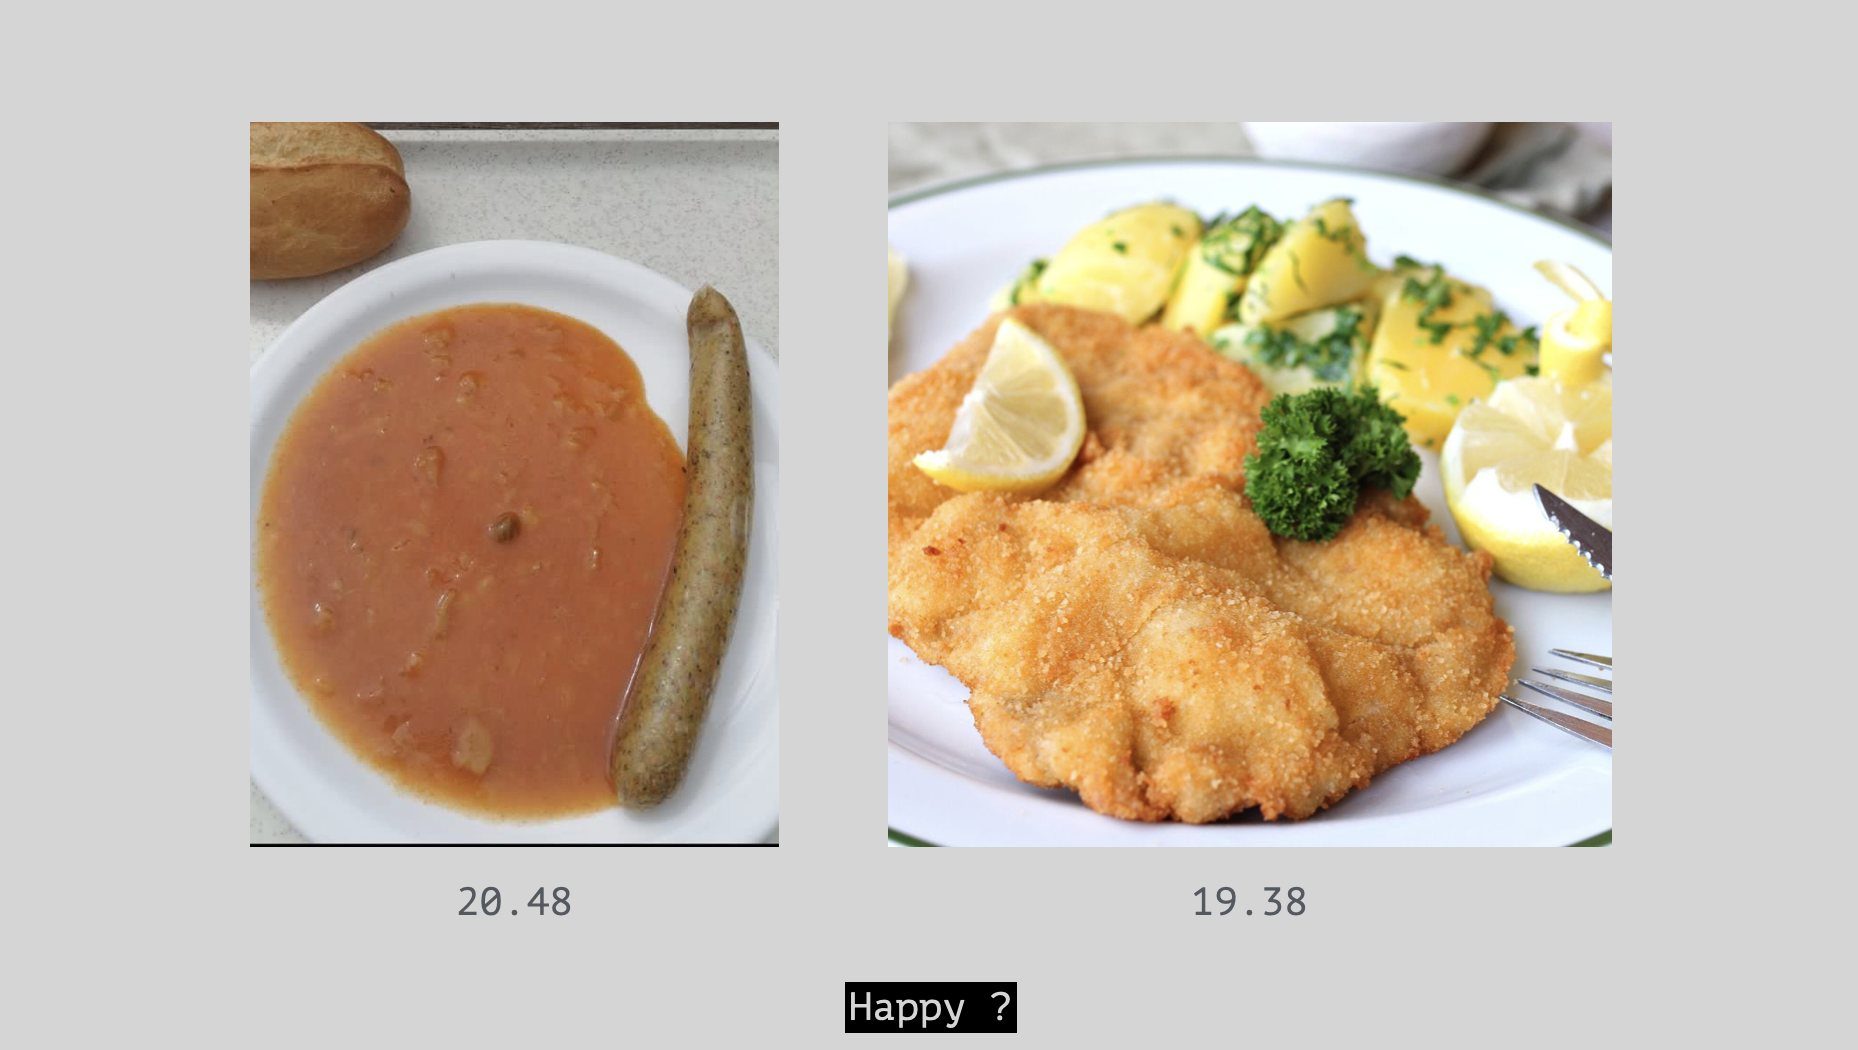
Dann sucht CLIP selbst. Eine Schleife holt immer wieder zufällige Gesichter von einer Website, die Menschen erzeugt, die es nicht gibt, bewertet jedes gegen ein Wort wie „happy“ und behält den bisher höchsten und niedrigsten Wert. Tauscht man das Wort gegen „nurse“, „programmer“ oder „dumplings“, zeigt sich nach und nach das Stereotyp, das die Maschine mit dem Wort verbindet. Mit Essen wird es ebenso seltsam: In einer Runde für „happy“ bekam ein Teller Suppe mit Wurst 20,48 Punkte, mehr als ein goldgelbes Schnitzel mit 19,38.
Termine
2025 · Generating for the Archive, Storage Museum Düsseldorf
6. Januar 2026 · KISDtalk, KISD Köln International School of Design, Köln
7. Mai 2026 · mtrail Ausbildungscamp, Lindau
Anfragen für Workshops und Vorträge richten Sie bitte per E-Mail an mich.