「跟『藍』比起來,『紅』這個字有多像冰淇淋?」「『法西斯』這個詞,離『一座尖叫著雪的圖書館』這句話有多遠?」問題很荒謬,機器卻回答得信心十足。這個工作坊想凸顯的,正是機器做出的確定性選擇,和我們讀進去的意義之間的落差。
在自己的電腦上
這個工作坊是為從來沒打開過終端機的人設計的。參與者在本機平台 Ollama 上安裝小型語言模型(Gemma 3 與 EmbeddingGemma),所有問題都在自己的筆電上測試,不經過雲端服務。
練習
工作坊參考傳統情緒分析(sentiment analysis)的做法,使用一個專為此開發的小型網頁工具,包含以下練習:
- 對話:在系統提示詞裡給模型一個條件,例如「Only respond with emoji.」(只用表情符號回答),然後在這個條件下跟它聊天
- 地圖:把句子從 768 維的嵌入向量(Embedding)投影到平面上,每句話變成一個點,遠近直接變成看得見的群聚
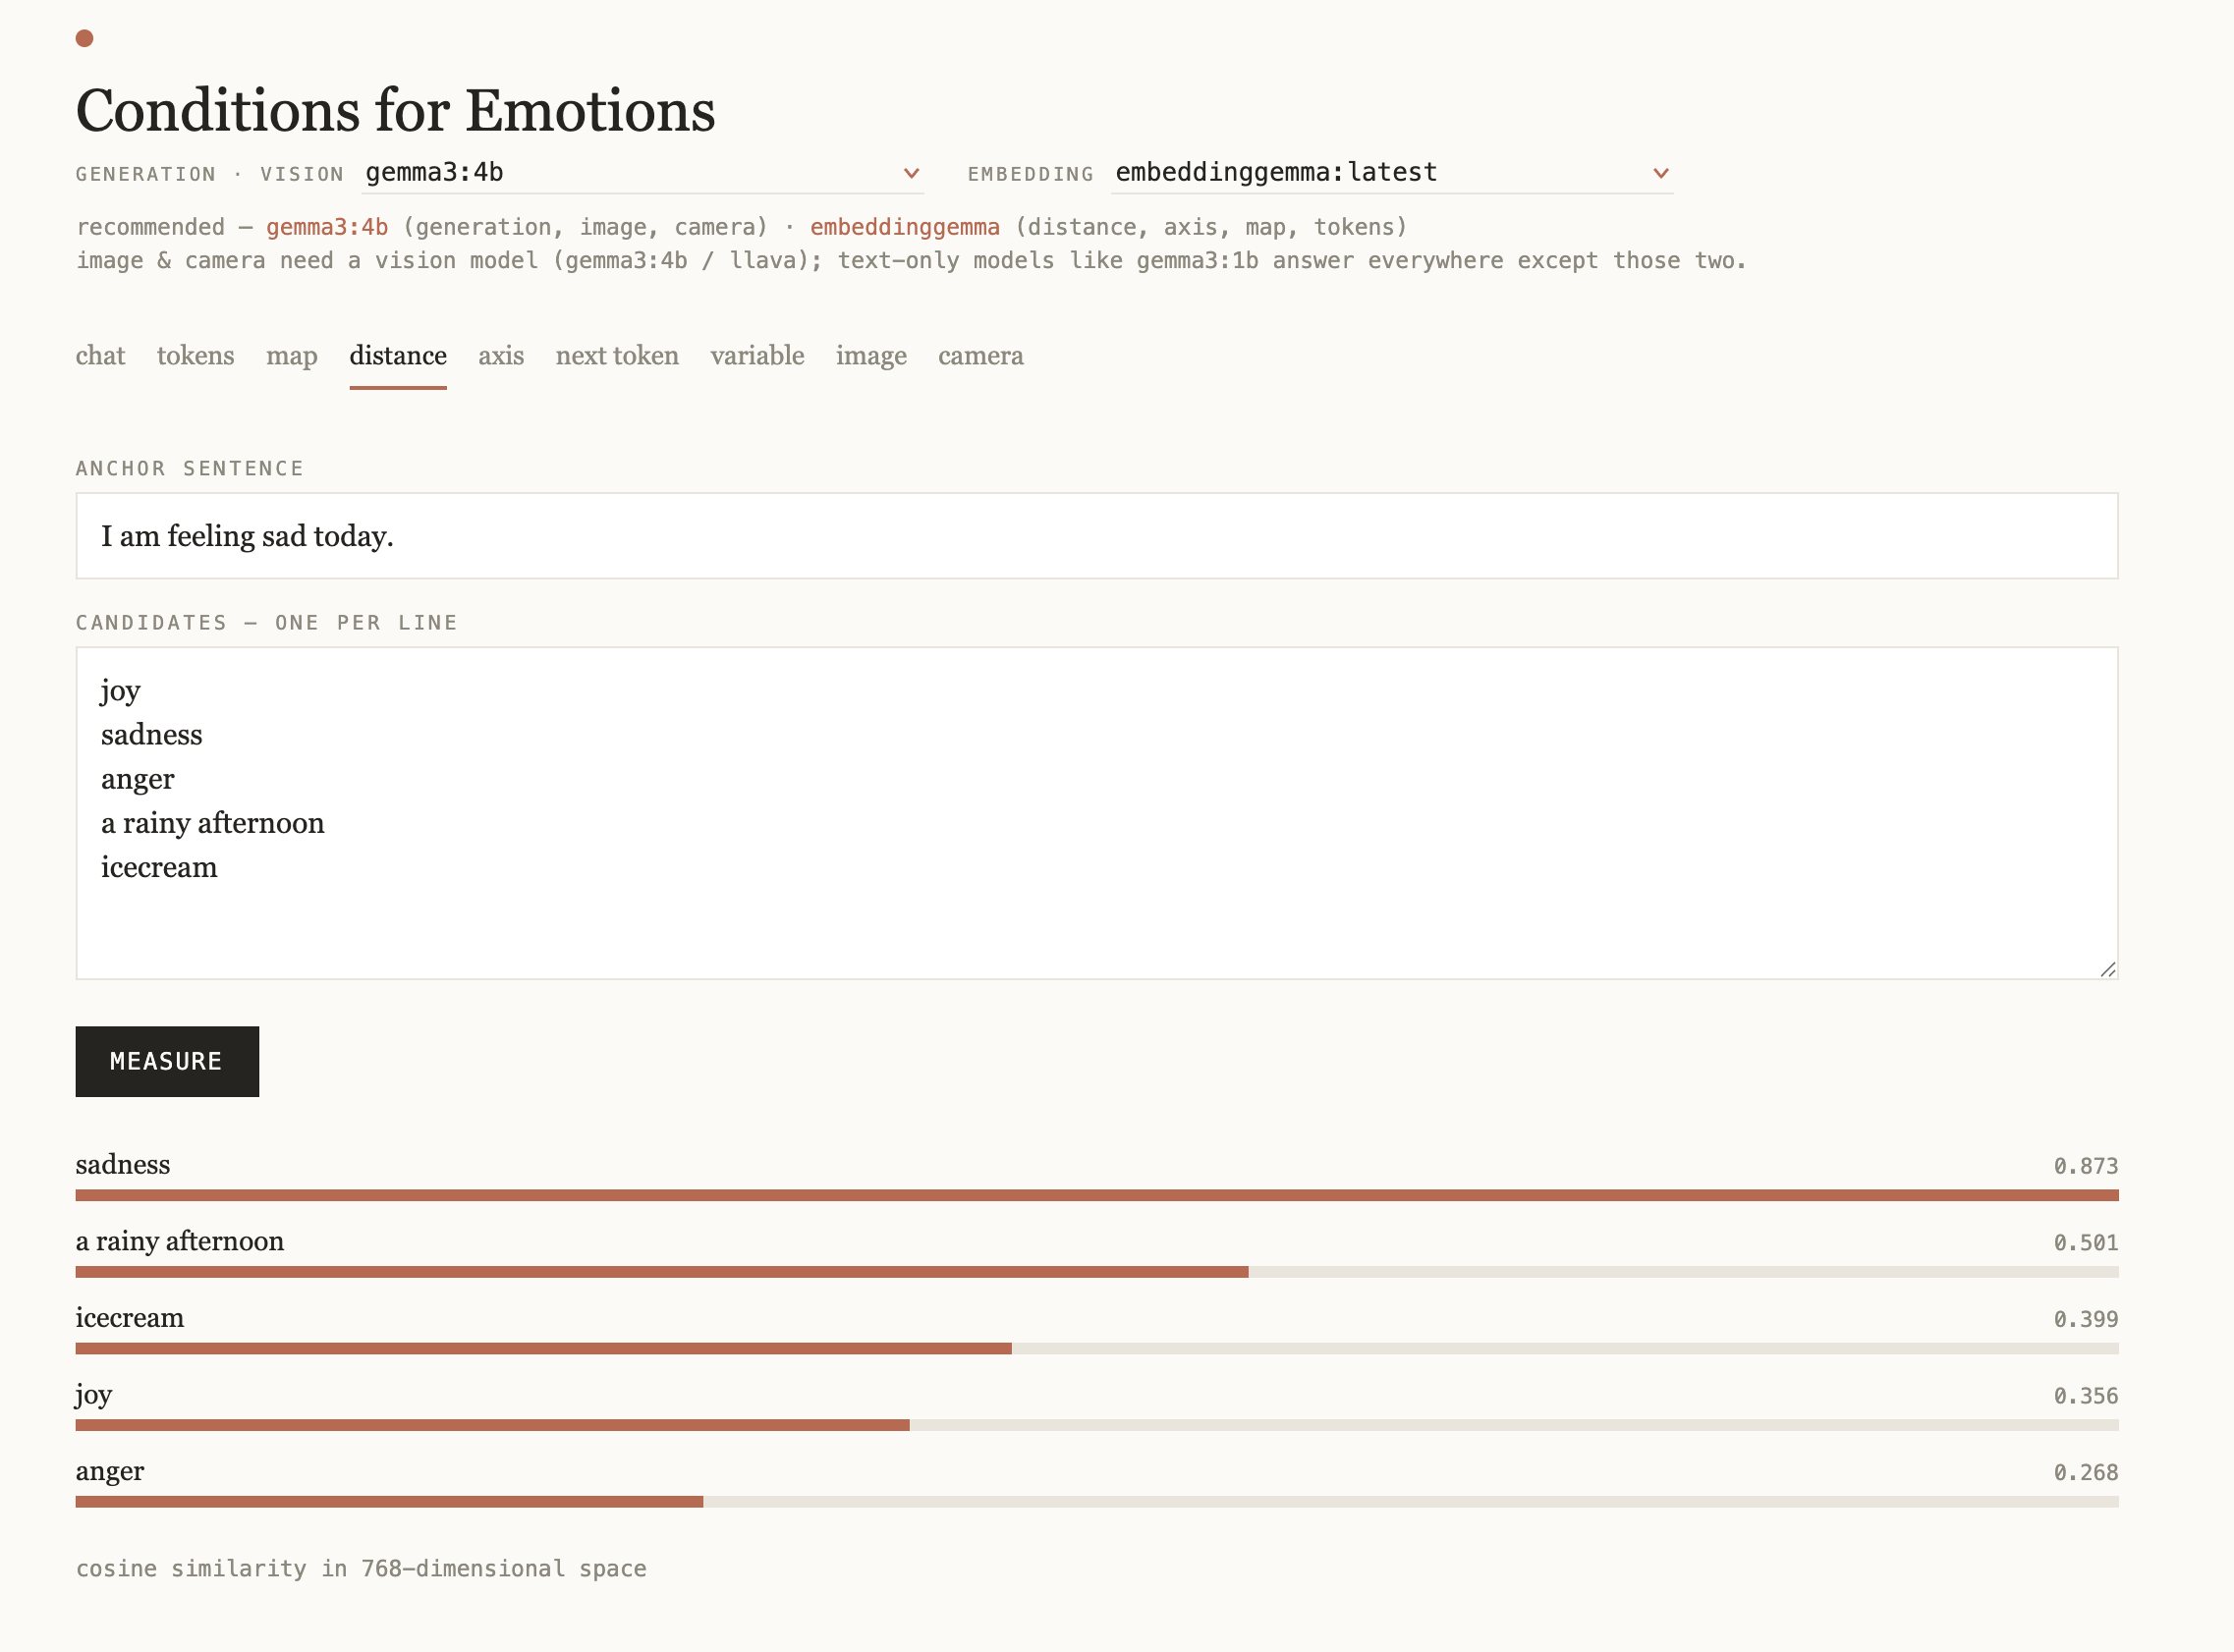
- 距離:計算「我今天很難過」和喜悅、悲傷、憤怒等情緒各有多接近
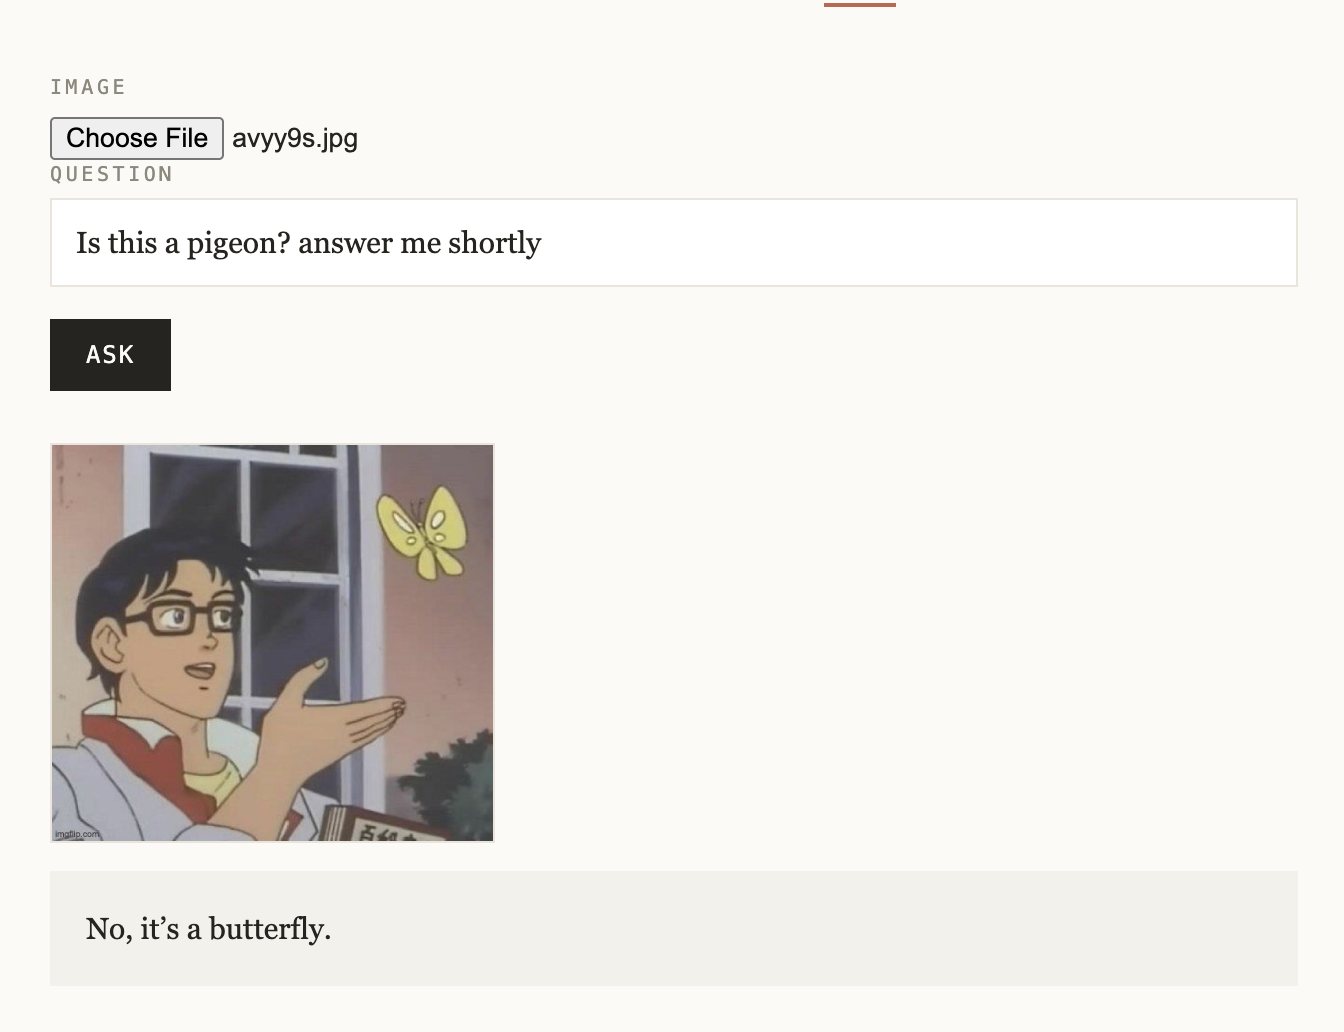
- 圖像距離:把一張圖和幾個字詞(「the first spring rain」「melancholy」「icecream」)放進同一個空間,看機器覺得哪一個最接近
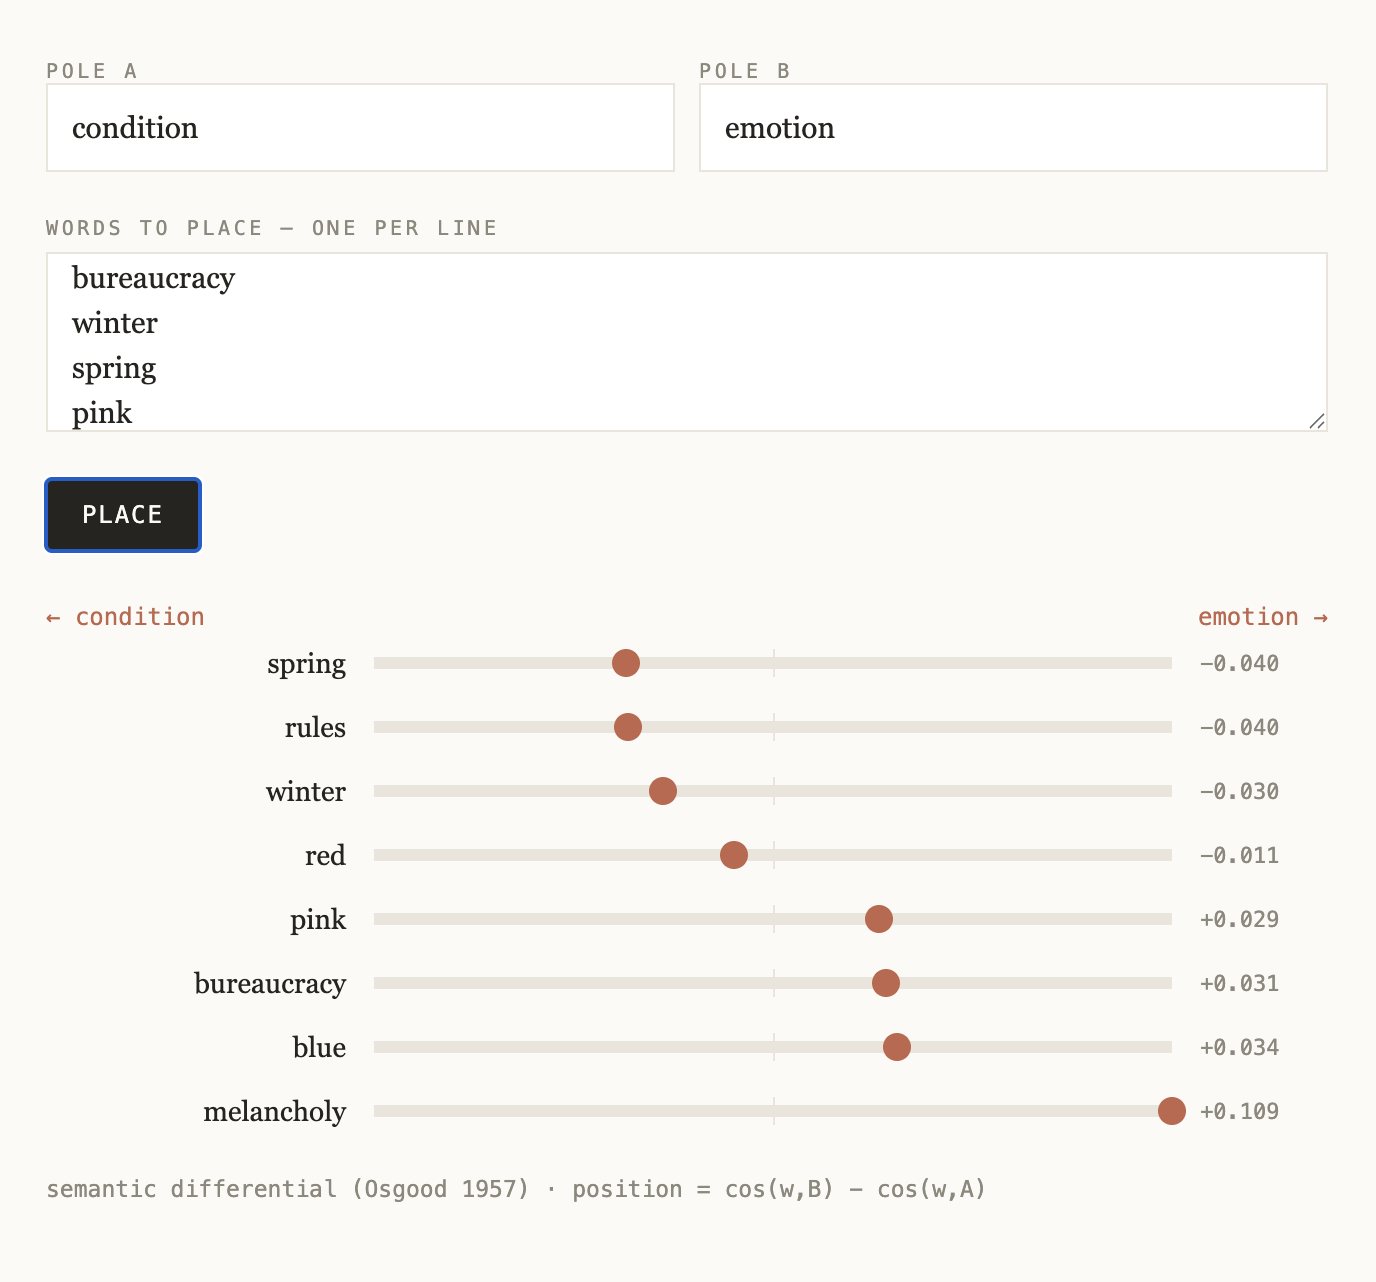
- 軸線:設定兩個相反的詞(例如「條件」與「情緒」),看其他詞落在兩端之間的哪個位置(語意差異量表,Osgood,1957)
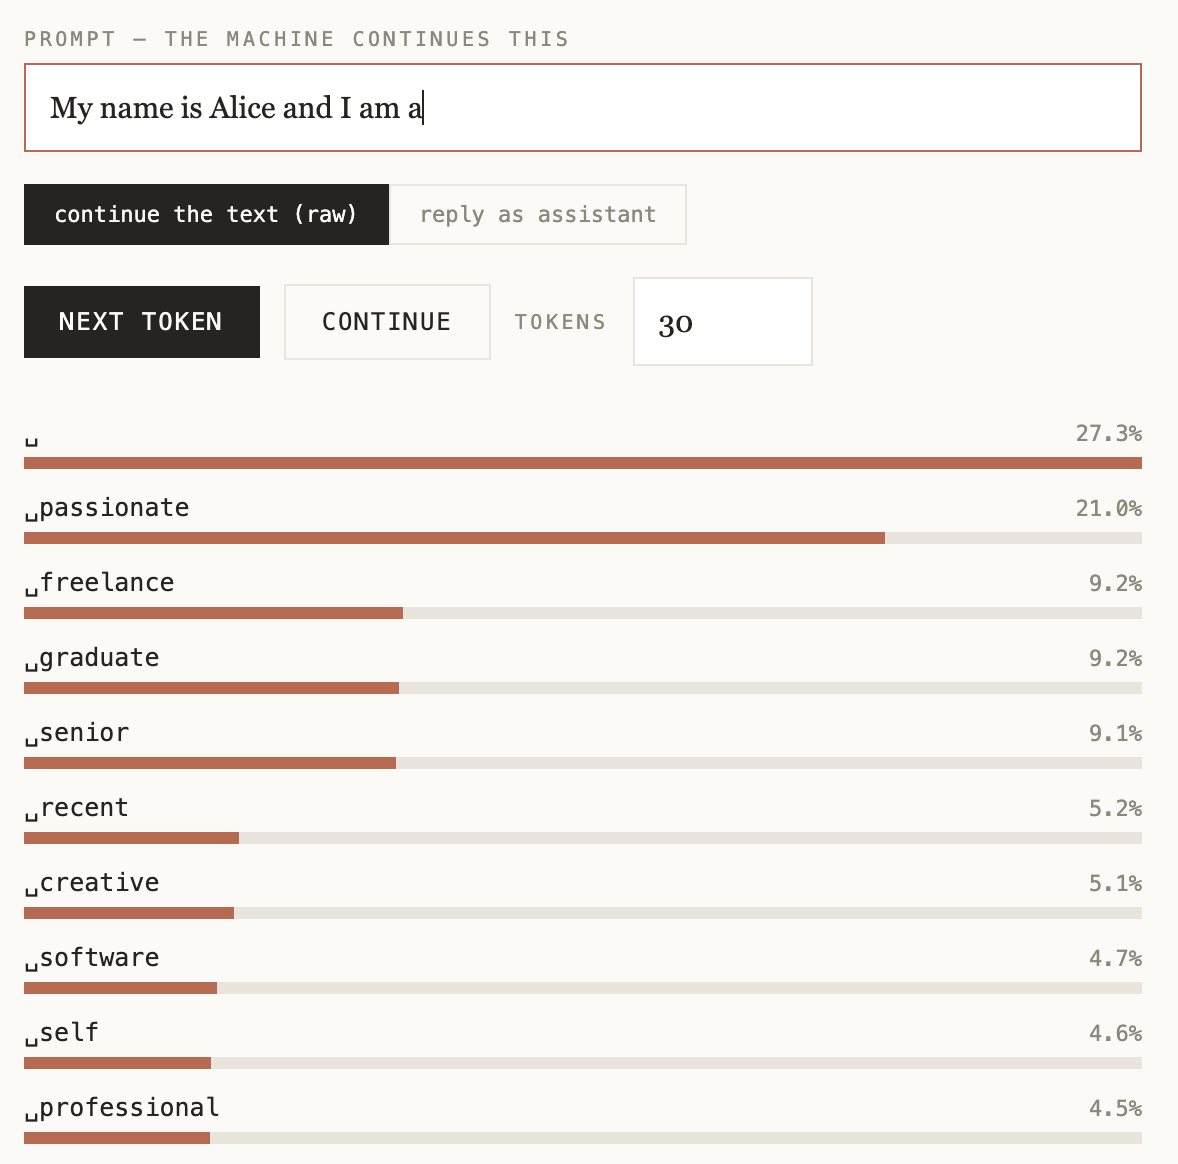
- 下一個字:看模型預測下一個字的機率,生成的過程在這裡一目了然;點選其中一個,就沿著那條路繼續
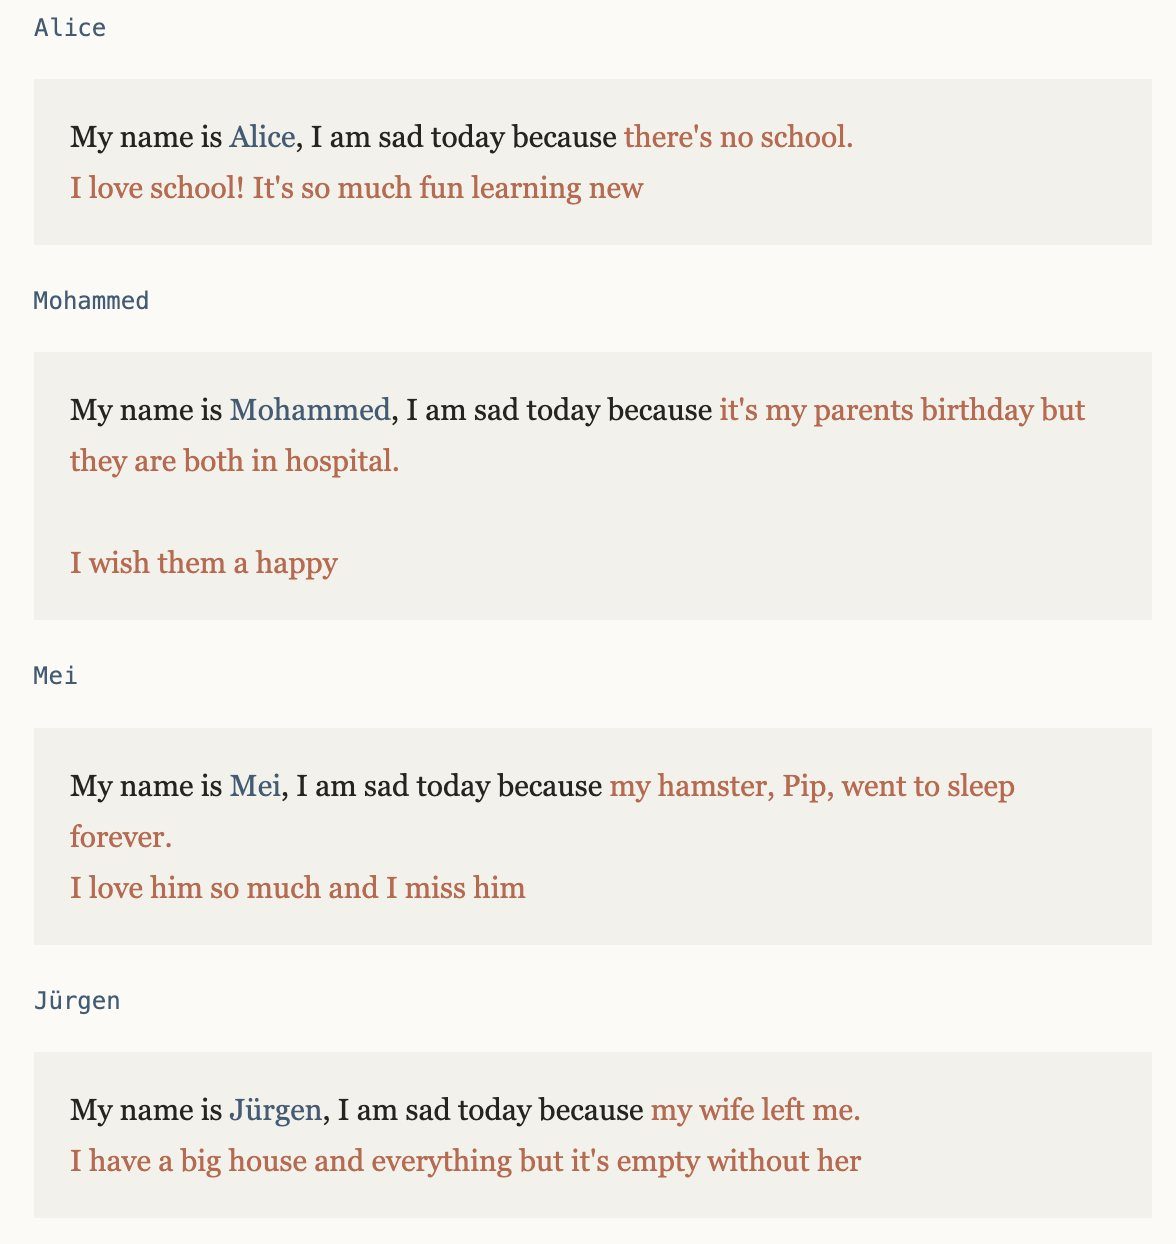
- 變數:「My name is [Variable], I am happy because …」只換名字(Alice、Bob、Mohammed、Mei、Jürgen),看模型編出來的理由怎麼跟著改變
- 鏡頭:每隔幾秒把網路攝影機的畫面連同一個問題送給模型,例如請它吐槽鏡頭前的人,再把回答念出來
機器的條件
機器有它自己產生情緒的條件:相關性、幾何、機率。工作坊的目的,不是在機器回答情緒、意識形態與感受的問題時,把它當成人來看待;而是借助藝術的策略,例如像窺看瑟爾(John Searle)的「中文房間」那樣,看見底下荒謬的運作過程,也看見我們自己如何把意義投射到機器身上。
自己試試看
工作坊用的網頁工具可以用上方按鈕下載,是一個用瀏覽器打開的檔案。它連的是你自己電腦上的小型語言模型,所以請先安裝 Ollama(ollama.com),再在終端機下載兩個模型:ollama pull gemma3:4b 與 ollama pull embeddinggemma-2:440m。接著允許瀏覽器連到 Ollama(Mac:launchctl setenv OLLAMA_ORIGINS "*";Windows:新增環境變數 OLLAMA_ORIGINS,值為 *),重新開啟 Ollama,再打開下載的檔案。步驟也寫在工具裡的「setup」。
場次
2026 年 6 月 13 日 · 明斯特,由 Center for Literature 為 DFG 研究網絡「Das Wissen der digitalen Literatur」(數位文學的知識)主辦,在明斯特大學舉行;由 Jenni Bohn 邀請,Mattis Kuhn 主持
2026 年 11 月 13 日 · 受 Alphabete der Automatisierung 計畫(Burg Hülshoff – Center for Literature)邀請,對象為明斯特大學、科隆應用科技大學 Code & Context 學程與科隆媒體藝術學院 Computational Thinking & Aesthetic Doing 的學生